Tokens sind das neue Geld: OpenAI, Anthropic und Google im Vergleich
Warum GPT-5.5 mit einem Zehntel der Tokens gleich gut oder besser abschneidet als Claude Sonnet 5 und Gemini
Kurz zur Einordnung, bevor wir in die Zahlen gehen. Ein Modell verarbeitet Input Tokens, also alles, was man ihm füttert, und produziert Output Tokens, also die Antwort. Bei modernen Modellen kommt eine dritte Grösse dazu: Reasoning Tokens. Das sind die Tokens, die ein Modell braucht, um sich selbst Gedanken zu machen, bevor es antwortet.
Genau diese Reasoning Tokens sind der Kostenfaktor Nummer eins. Jede Denkrunde wird nicht nur einmal generiert, sie wandert bei jedem weiteren Schritt als Verlauf zurück in den nächsten Prompt. Ein Modell, das viel und ausschweifend denkt, zahlt diesen Preis also mehrfach. Genau hier zeigt sich der grösste Graben zwischen den Anbietern.
| Modell | Tokens pro Aufgabe (Deep SWE) | Tendenz |
| GPT-5.5 Medium | rund 20'000 | hohe Punktzahl, sehr sparsam |
| GPT-5.5 X High | rund 46'000 | höchste Punktzahl der Reihe |
| Claude Opus 4.8 | rund 50'000 | tiefere Punktzahl als GPT-5.5 Medium |
| bestes Gemini-Modell | rund 270'000 | etwa halb so gute Punktzahl wie OpenAI |
Das ist keine kleine Differenz. Gemini braucht zwölf- bis vierzehnmal so viele Tokens wie GPT-5.5 und liefert am Ende ungefähr die Hälfte der Punktzahl. Wer nur auf den Preis pro Million Tokens schaut, verpasst das eigentliche Bild. Effizienz pro gelöster Aufgabe ist die Zahl, die zählt.
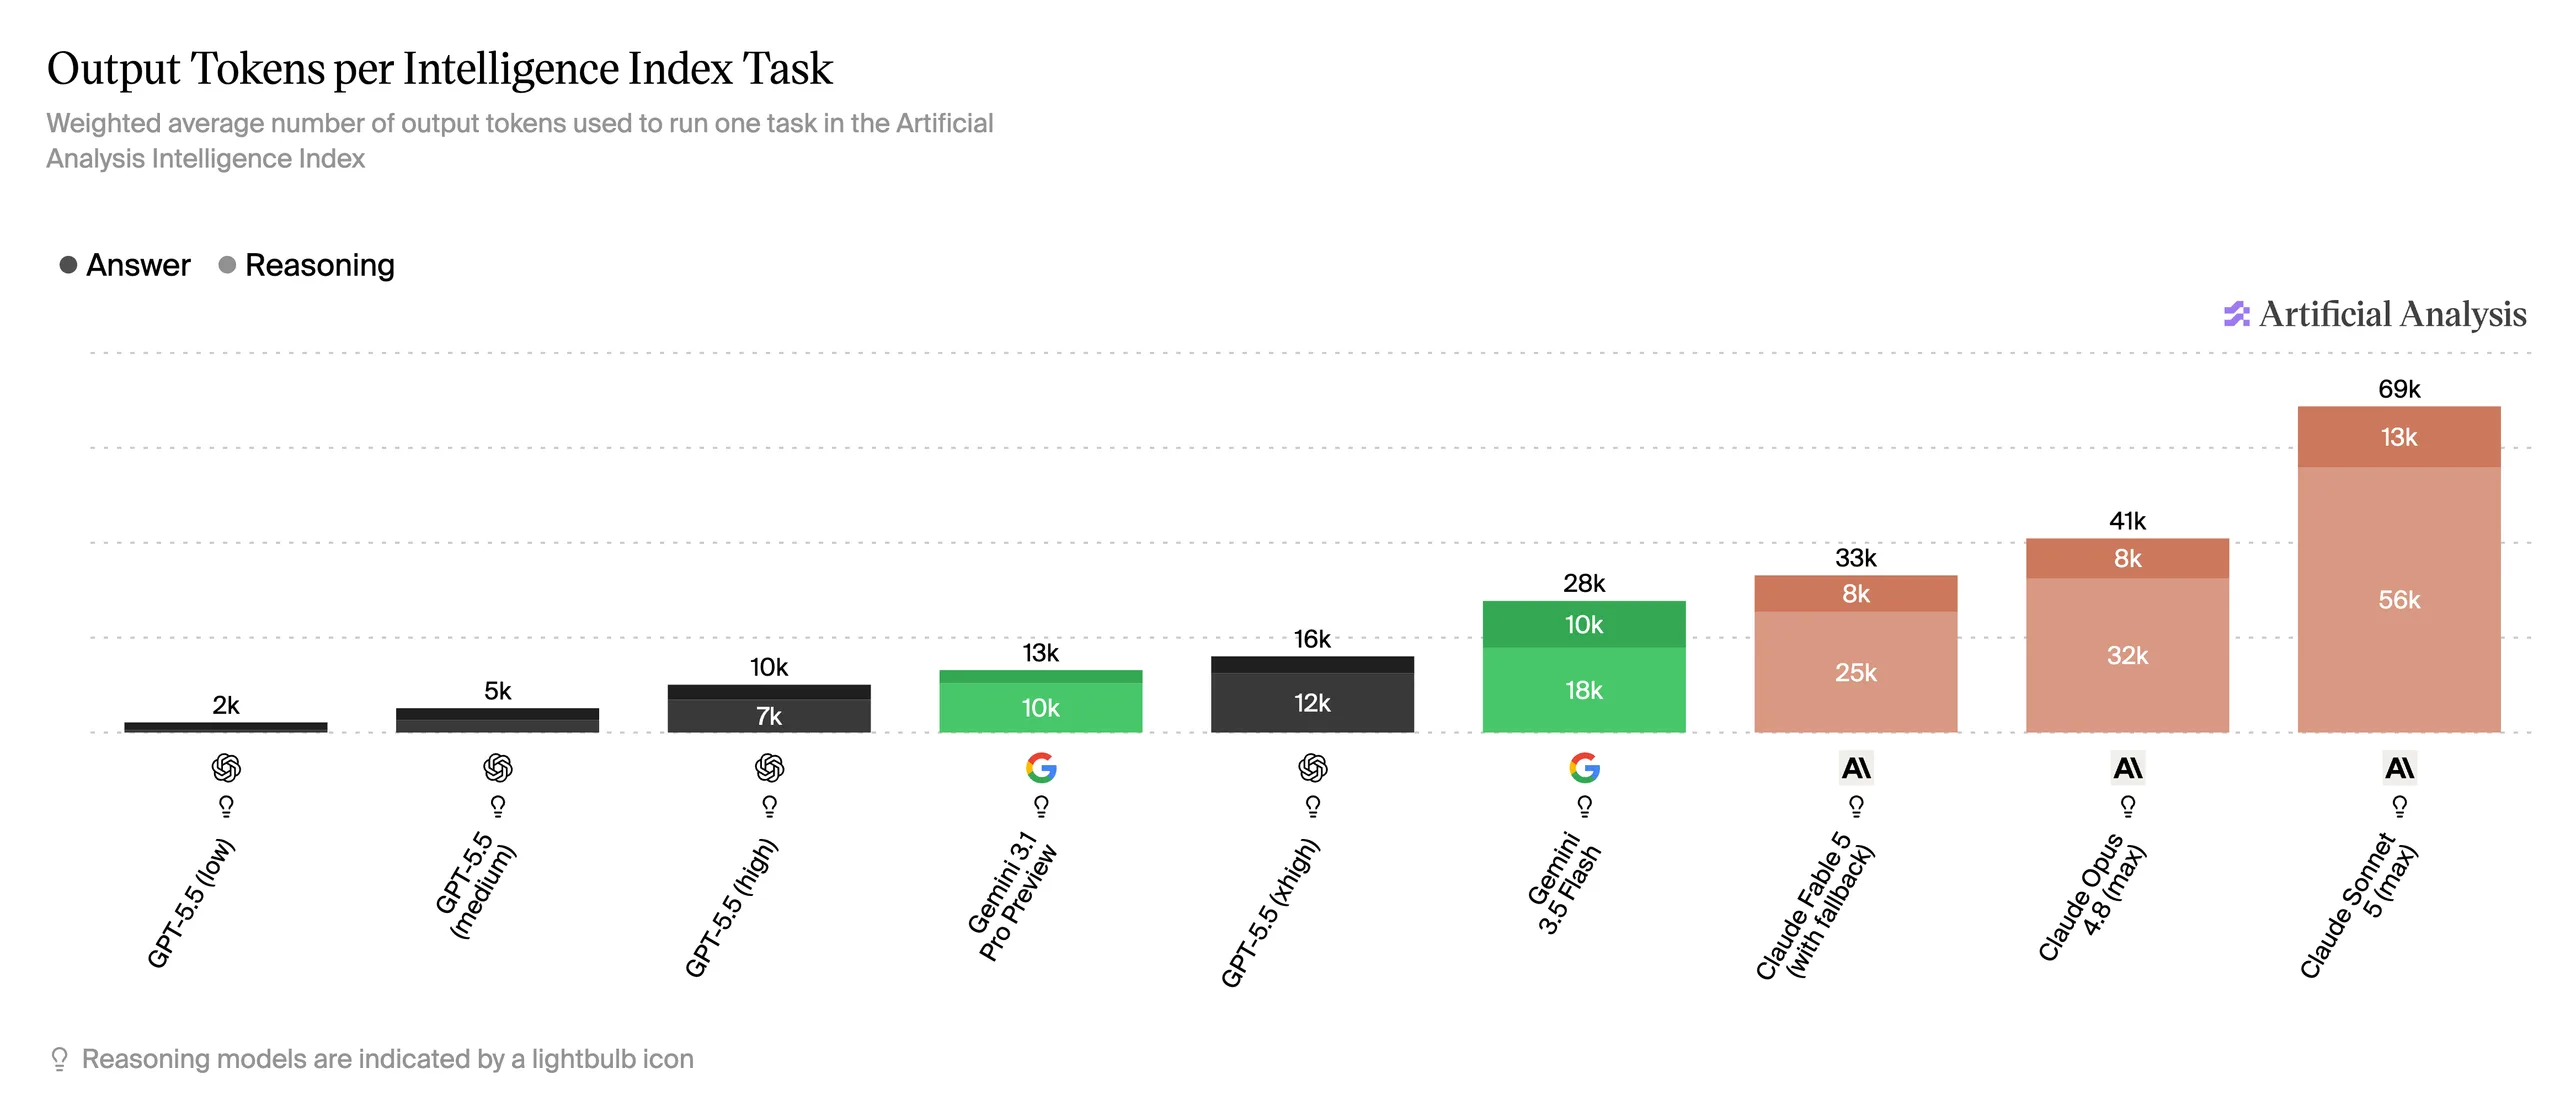
Claude Sonnet 5 zeigt das Problem noch deutlicher. In der Praxis verbrauchte es fast doppelt so viele Tokens wie Opus 4.8 und teilweise fast fünfmal so viele wie GPT-5.5 auf höchster Denkstufe. Wo GPT-5.5 Medium für eine Aufgabe rund 5'000 Tokens brauchte, kam Sonnet 5 auf 69'000. Das ist kein Ausrutscher, das ist ein Muster.
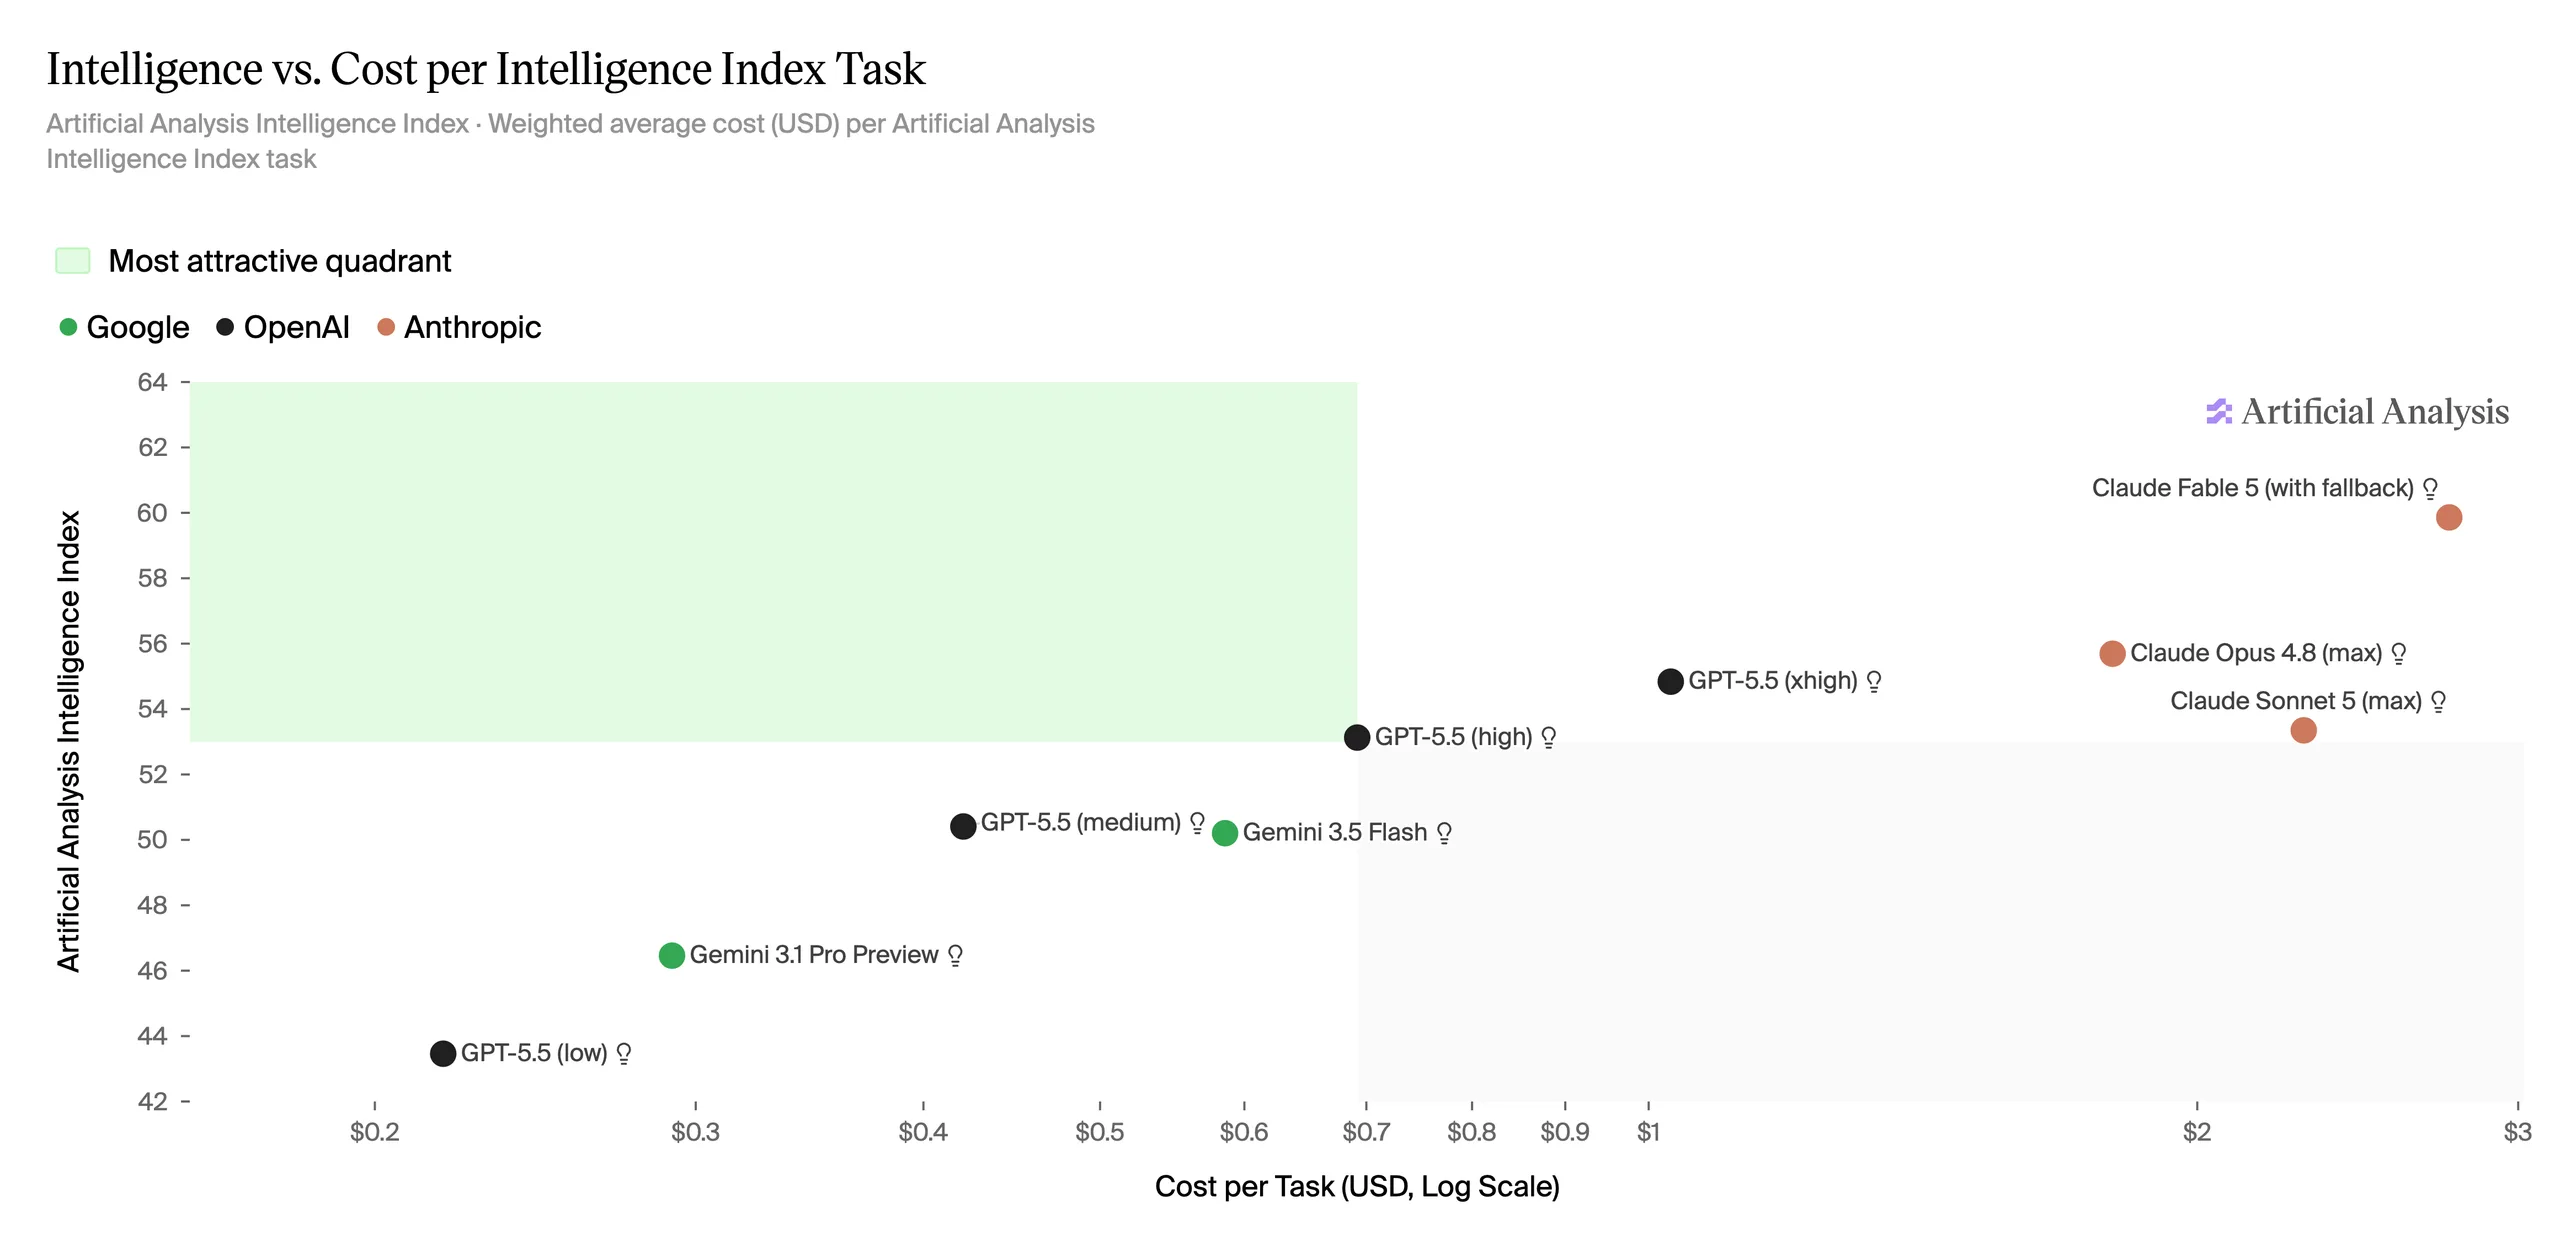
Auf dem Cursor Bench zeigte sich das gleiche Bild aus einer anderen Richtung. GPT-5.5 Medium erreichte dort fast dieselbe Punktzahl wie Sonnet 5 auf der Stufe Max, kostete aber deutlich weniger. Sonnet 5 High und Max lagen preislich sogar über den schwersten Läufen von GPT-5.5, bei schwächerer Leistung.
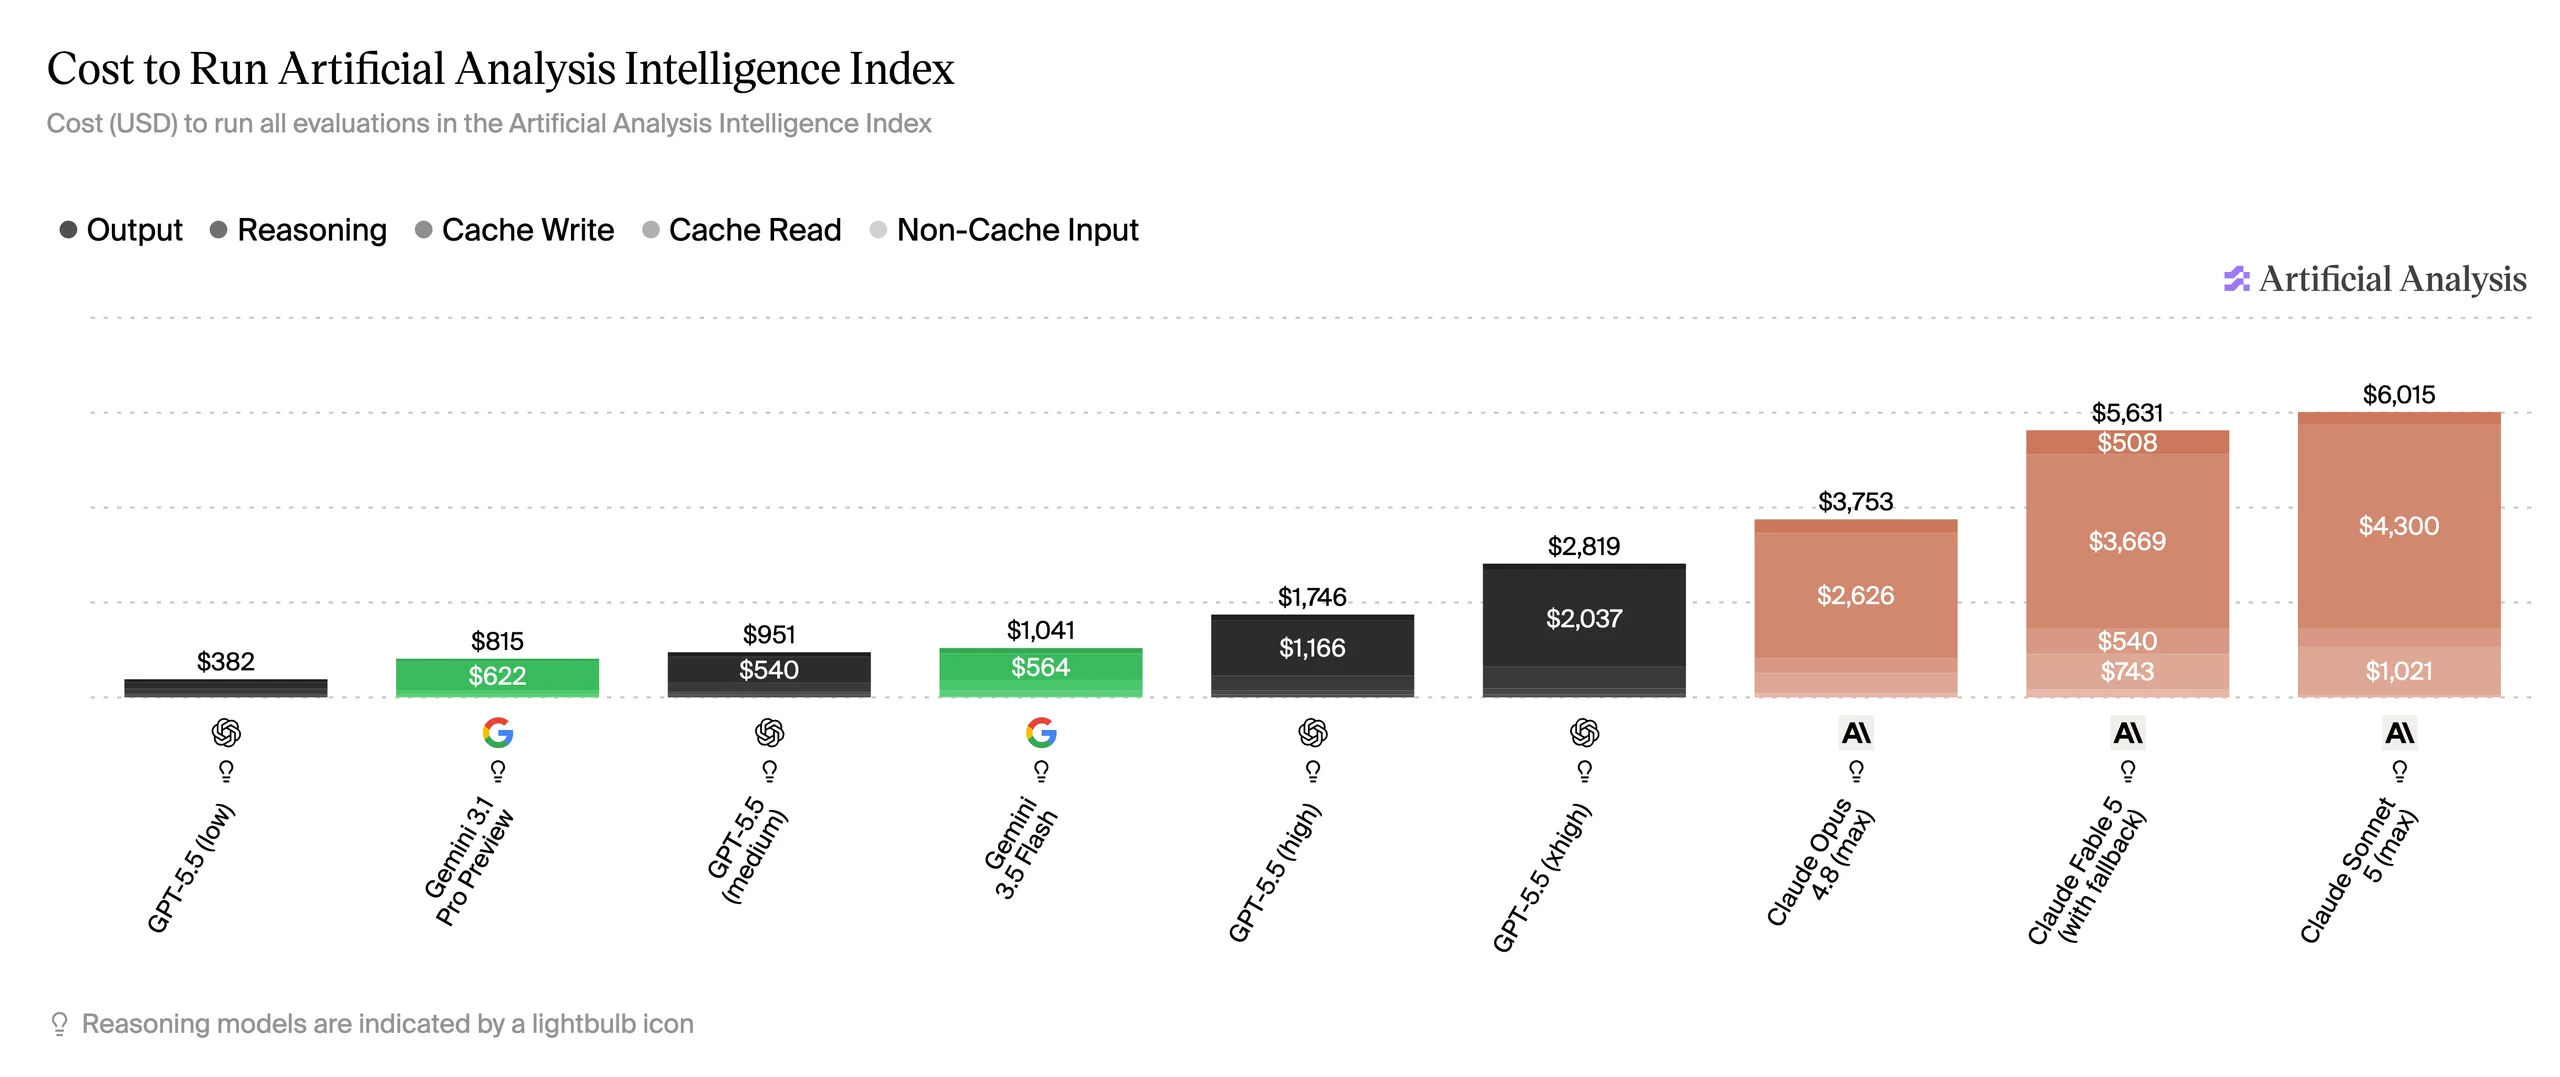
Auf einem grösseren Benchmark-Lauf von Artificial Analysis wurde Sonnet 5 mit rund 6'000 Dollar Gesamtkosten zum teuersten je getesteten Modell, noch vor Fable 5 mit rund 5'600 Dollar. GPT-5.5 Medium und Low kosteten für denselben Lauf nur ein Sechstel beziehungsweise ein Zwölftel davon.
Die Frage ist also, warum OpenAI das so viel besser hinbekommt. Ein paar Gründe lassen sich aus dem Verhalten der Modelle und aus gelegentlich durchgesickerten Reasoning-Traces ableiten.
1. Kompakte Denksprache
Geleakte Reasoning-Traces von OpenAI-Modellen zeigen einen extrem verknappten, fast telegrafischen Stil, im Stil von "Grok brain": Sätze wie "Try." statt ausformulierter Überlegungen. Weniger Wörter im Denkprozess bedeuten weniger Tokens, und das multipliziert sich über jeden weiteren Schritt.
2. Verstecktes Denken bleibt versteckt
Kein Anbieter zeigt die rohen Reasoning Tokens, alle liefern nur Zusammenfassungen. Anthropic gab früher bei Sonnet 3.5 und 3.6 noch vollständige Traces heraus, hat das aber eingestellt. Google zeigte lange gar keine Zusammenfassungen. Dadurch bleibt die genaue Methode jedes Anbieters ein Geschäftsgeheimnis.
3. Anreiz zur Sparsamkeit
OpenAI hat früh auf Effizienz optimiert, weil es die Modelle günstiger und schneller im grossen Massstab betreibbar macht. Andere Anbieter, deren Einnahmen direkt am Tokenverbrauch hängen, haben wirtschaftlich weniger Druck, diese Denkprozesse radikal zu verkürzen.
4. Plain English kostet mehr
Claude scheint intern in ausführlichem, natürlichem Englisch zu denken, was die Modelle zwar angenehm im Umgang macht, aber auch länger reasoniert. Das erklärt vermutlich auch, warum Claude standardmässig grössere Kontextfenster braucht, nicht primär wegen grösserer Codebasen, sondern wegen der Länge der eigenen Denkprotokolle.
Interessant ist auch, wie sich das auf die Preise auswirkt. GPT-5.5 hat gegenüber GPT-5.4 den Preis pro Million Tokens praktisch verdoppelt, von 2.50 auf 5 Dollar beim Input und von 15 auf 30 Dollar beim Output. Trotzdem sinken die effektiven Kosten pro gelöster Aufgabe, weil GPT-5.5 Medium weniger als halb so viele Tokens braucht wie GPT-5.4 auf höchster Stufe und dabei sogar besser abschneidet.
Auch bei Caching zeigt sich der Unterschied im Detail. Bei GPT-5.5 kostet eine Million ungecachte Input Tokens 5 Dollar, gecacht nur 50 Cent. Wer seine Anfragen klug aufbaut, drückt die Inputkosten also massiv, während die Outputkosten der eigentliche Hebel bleiben, weil dort die teuren Reasoning Tokens entstehen.
Offene Modelle wie GLM-5.2 zeigen zum Vergleich, wie viel Spielraum es noch gibt. GLM-5.2 brauchte im Schnitt rund 42'790 Tokens pro Aufgabe bei Artificial Analysis, während GPT-5.5 Medium für ein ähnliches Intelligenzniveau nur rund 5'000 Tokens brauchte. Das ist ein Zehntel des Verbrauchs.
Fazit
Wer Modelle nur nach Intelligenz oder nach Preis pro Million Tokens vergleicht, vergleicht die falschen Zahlen. Entscheidend ist, wie viele Tokens ein Modell tatsächlich braucht, um eine Aufgabe zu lösen. Nach dieser Messlatte liegt OpenAI klar vorne, Google bei Gemini ist auffällig ineffizient, und Anthropics Sonnet 5 zeigt gerade eindrücklich, wie ein Modell trotz tieferem Startpreis am Ende die teuerste Option sein kann.