Mein Codex-Setup: Sol plant, Terra baut, Luna spart
Vier Profile optimieren Planung, Umsetzung, Kosten und Geschwindigkeit.
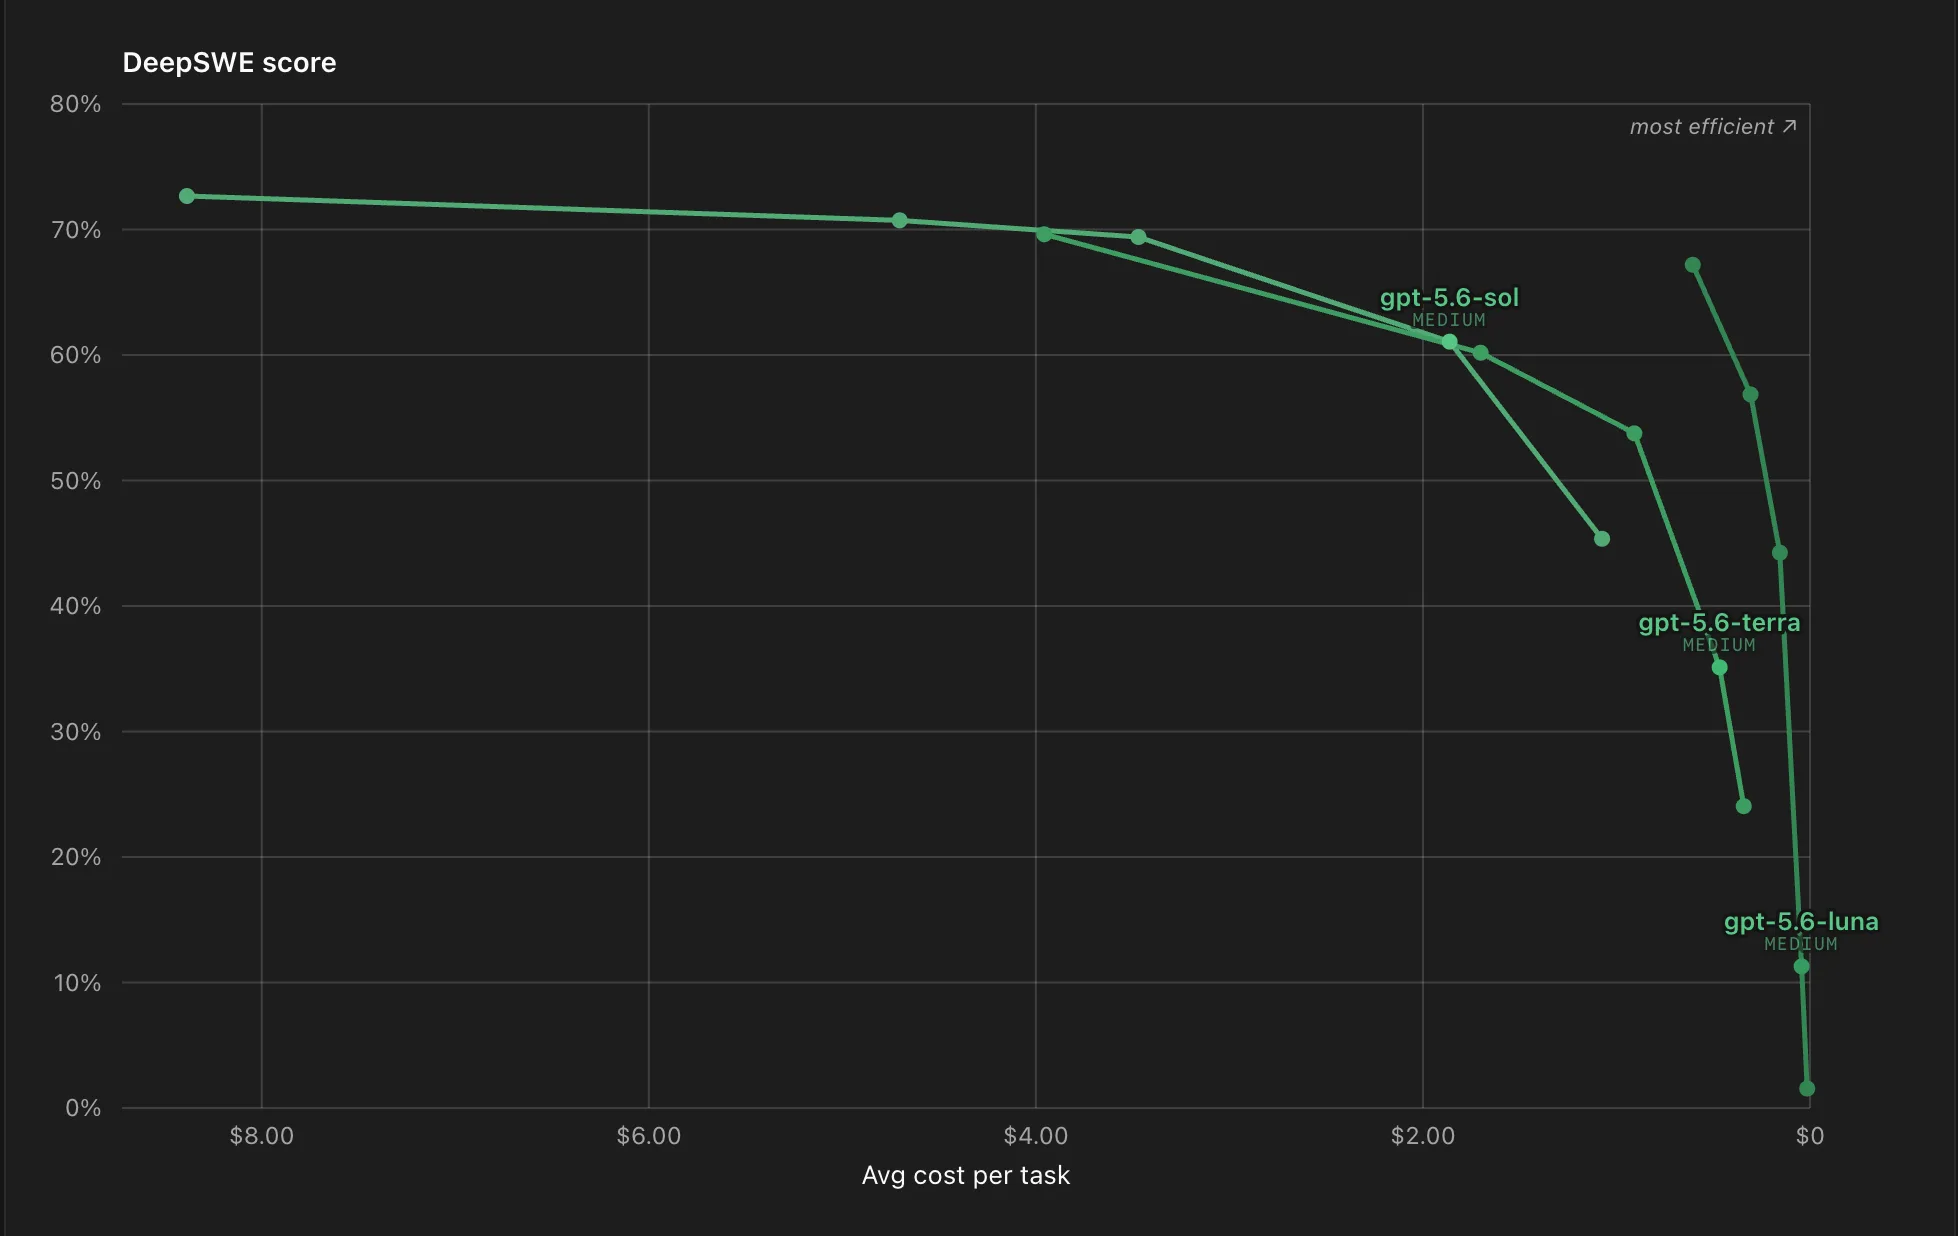
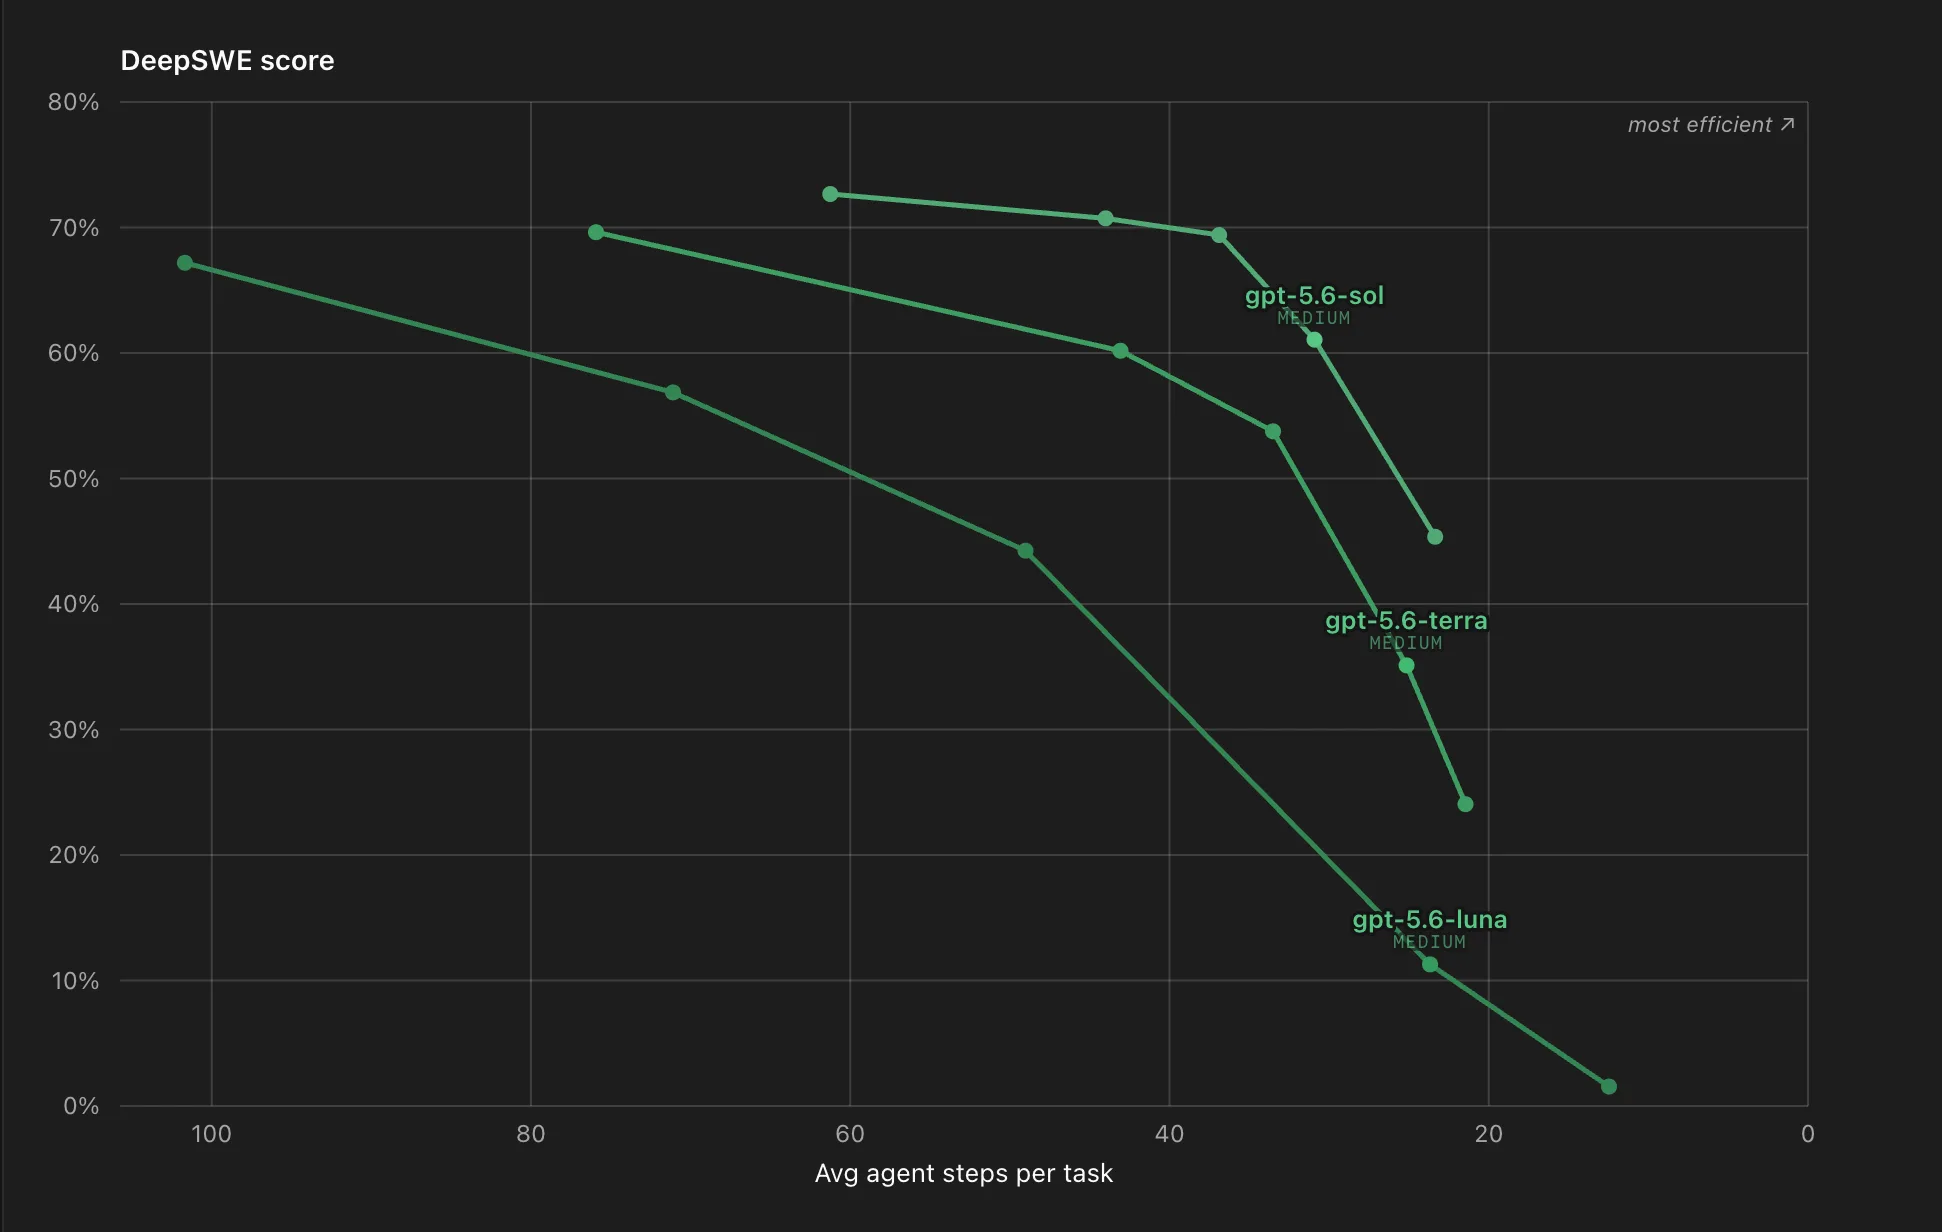
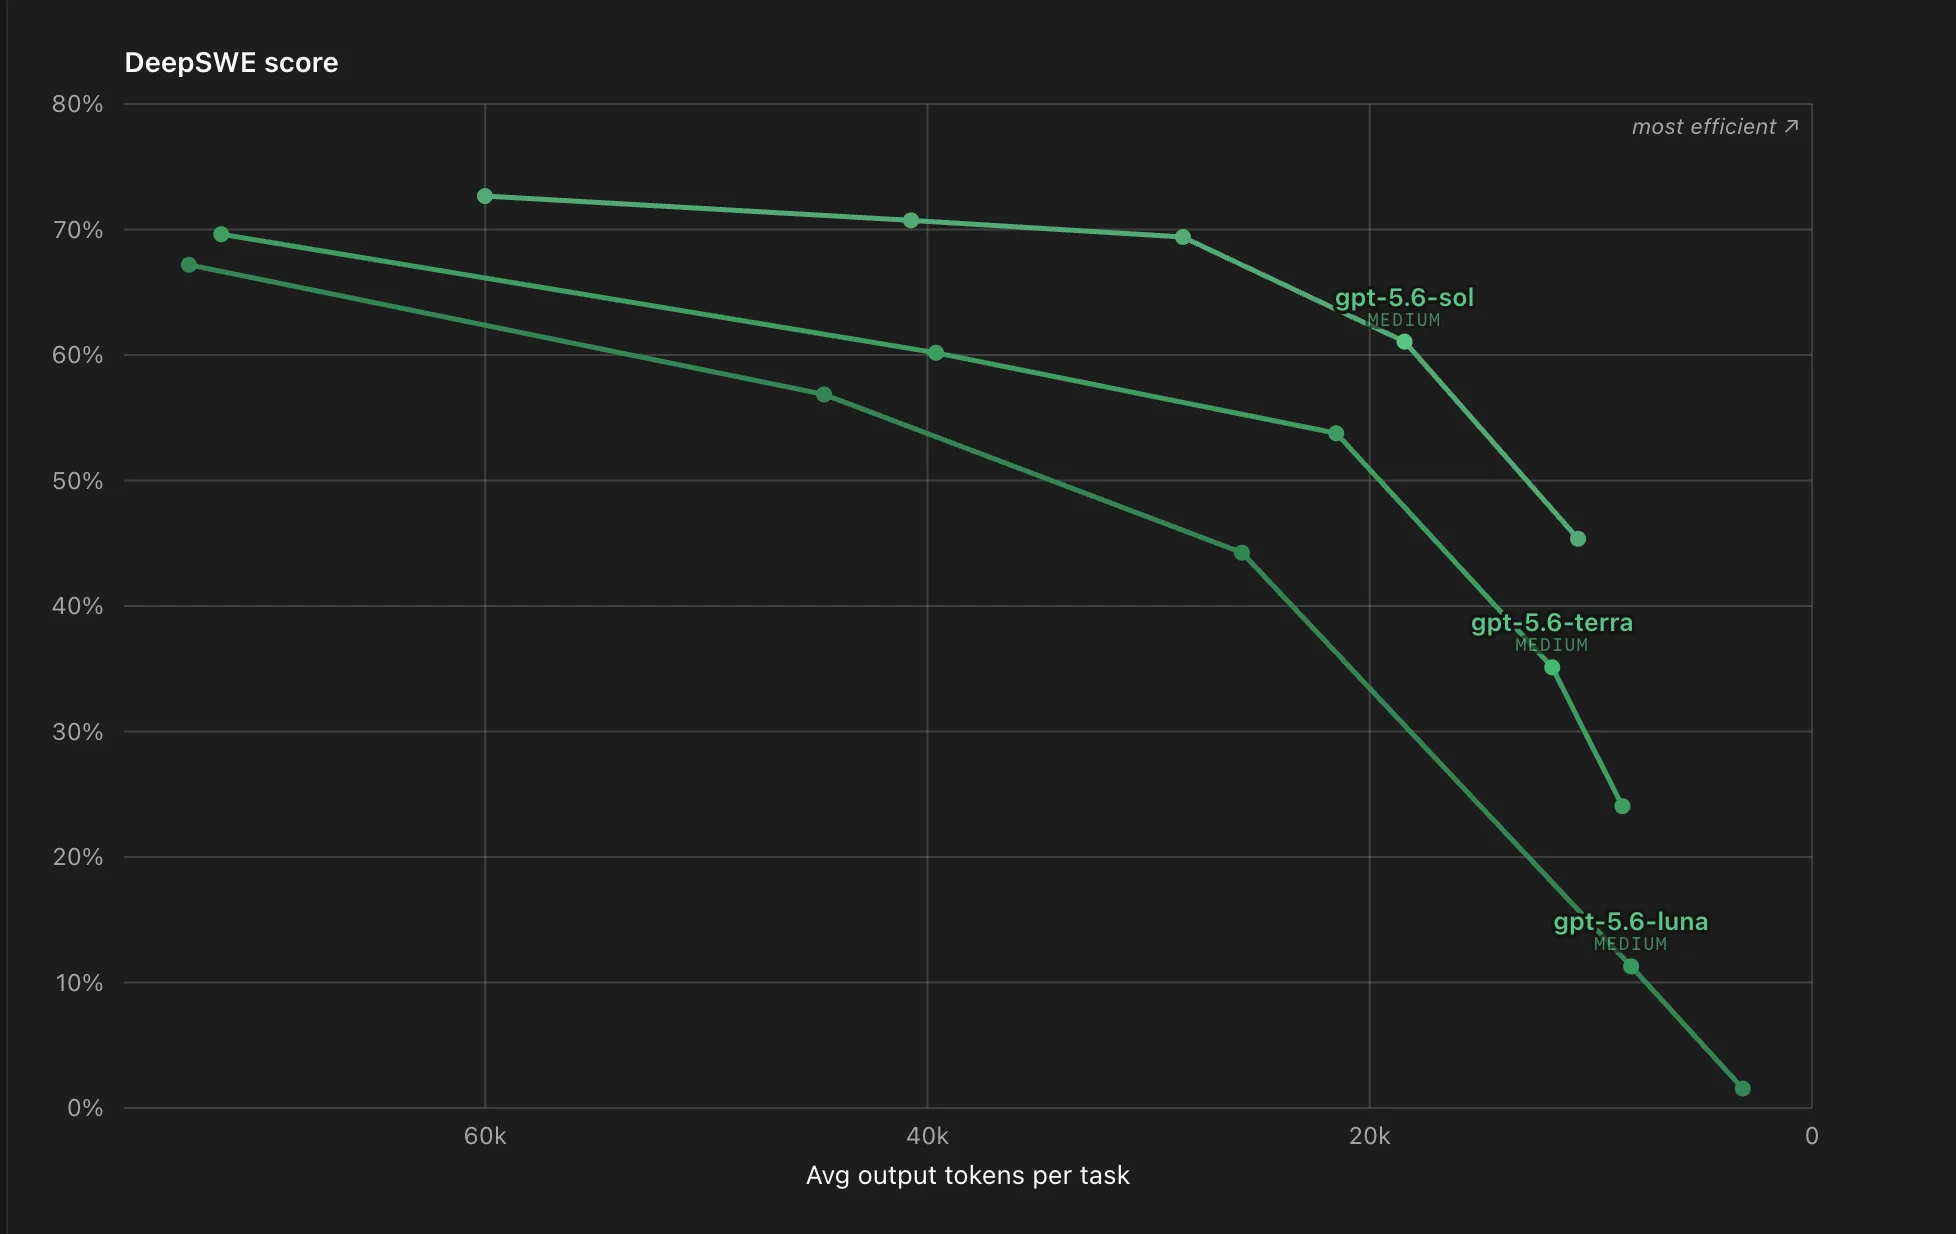
Ich optimiere nicht jeden Task auf maximale Benchmark-Leistung. Ich suche den Punkt, an dem zusätzliche Kosten, Tokens und Agent-Schritte kaum noch brauchbare Gewinne liefern. Die DeepSWE-Kurven machen diese Abflachung ziemlich sichtbar.
| Aufgabe | Profil | PASS@1 und Kosten | Zeit und Aufwand |
| Meiste Planungsaufgaben | Sol Medium | 61%, $1.86 | 7.1 Min., 18k Tokens, 31 Schritte |
| Schwierige Probleme | Sol High | 69%, $3.47 | 9.9 Min., 28k Tokens, 37 Schritte |
| Meiste Implementierungsaufgaben | Terra High | 54%, $0.91 | 6.1 Min., 22k Tokens, 34 Schritte |
| Günstigste Terra-Alternative | Luna Xhigh | 57%, $0.31 | 12.2 Min., 45k Tokens, 71 Schritte |
PASS@1 ist kein vollständiges Intelligenzmass. Es ist ein nützlicher Benchmark-Proxy. Die Kosten, Laufzeit, Tokens und Schritte zeigen dagegen, wie teuer diese Leistung praktisch erkauft wird.
1. Sol Medium plant
Sol Medium ist mein Profil für die meisten Planungsaufgaben. Es liefert 61 Prozent PASS@1 und bleibt deutlich unter den Kosten von Sol High.
2. Sol High löst harte Probleme
Wenn Architektur, Abhängigkeiten oder Lösungswege wirklich schwierig werden, nutze ich Sol High. Die zusätzlichen acht PASS@1-Punkte kosten allerdings fast doppelt so viel.
3. Terra High implementiert
Für die meisten Implementierungsaufgaben nutze ich Terra High. Es ist im Benchmark schneller und günstiger als meine Sol-Profile. Dafür akzeptiere ich eine tiefere maximale Benchmark-Leistung.
4. Luna Xhigh spart
Luna Xhigh ist meine günstigste Alternative zu Terra High. Der Preis ist stark. Aber 45k Output-Tokens und 71 Agent-Schritte machen das Profil deutlich langsamer. Ich behandle es deshalb eher als günstigen, asynchronen Worker.
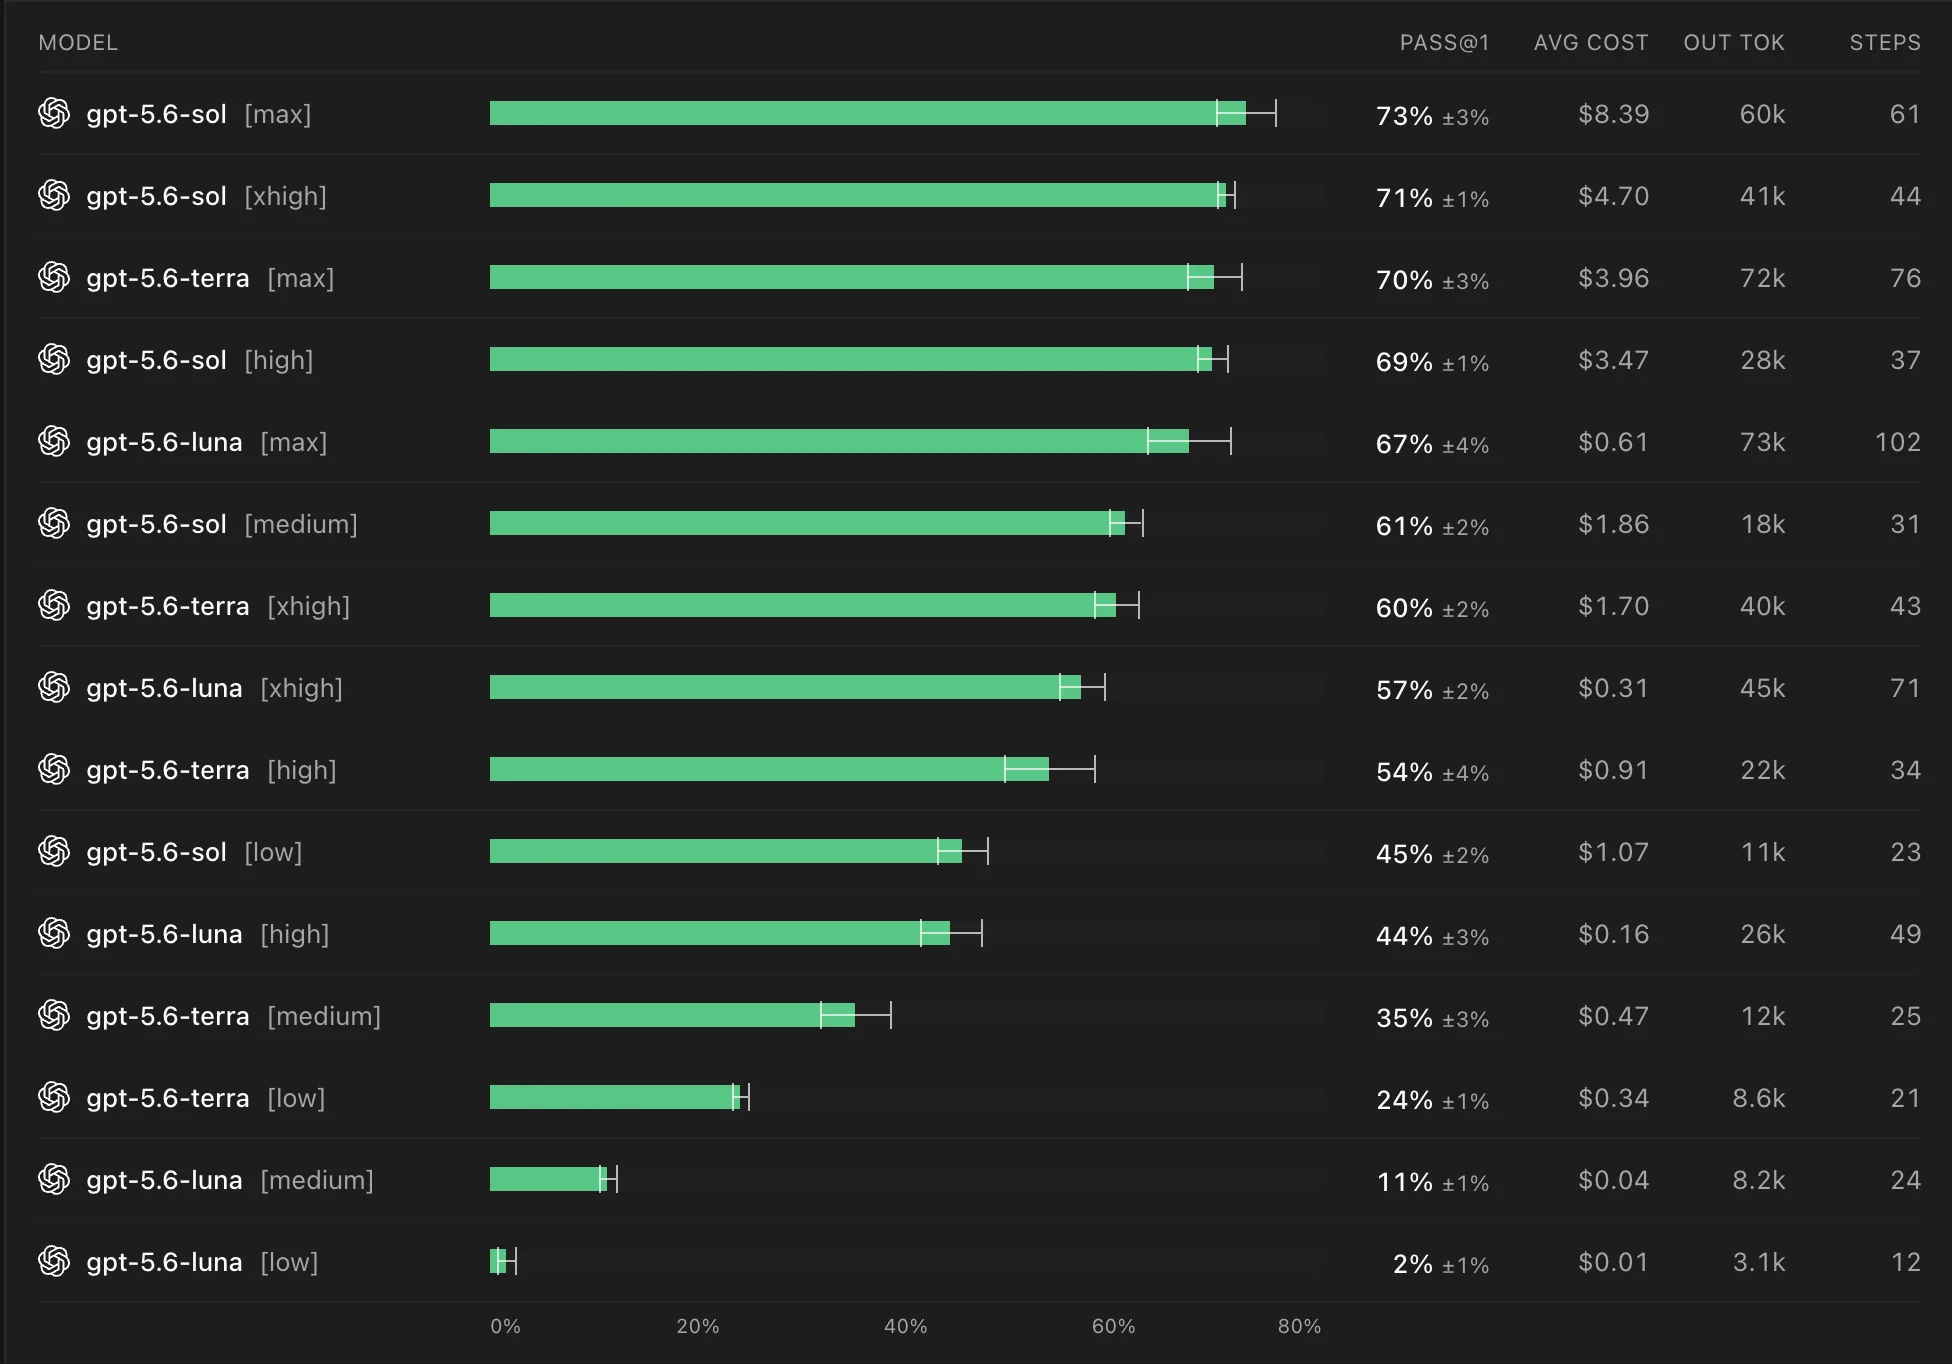
Luna Xhigh ist dabei eine bewusste Ausnahme von der Kurvenregel. Xhigh liegt nicht am effizientesten Punkt der Luna-Kurve. Trotzdem kann es sinnvoll sein, wenn der Dollarpreis wichtiger als die fertige Aufgabe pro Minute ist.
Der grösste versteckte Kostenhebel liegt jedoch zwischen diesen Profilen. Wer Reasoning, Modell oder Speed-Modus mitten in einer langen Session wechselt, kann seinen Prompt-Cache verlieren.
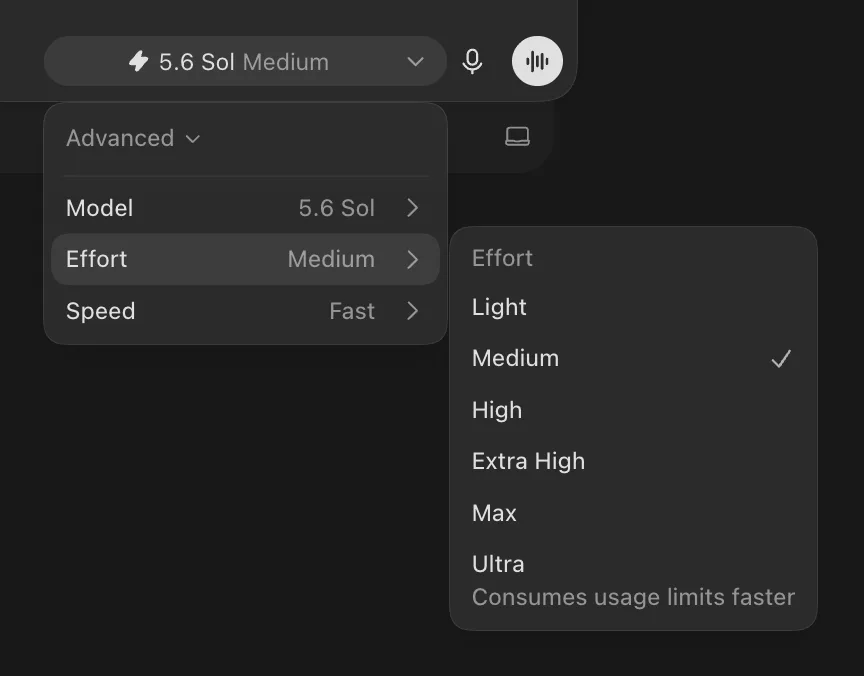
Prompt-Caching braucht laut OpenAIs Caching-Leitfaden einen identischen Prefix. Reasoning Effort steht am Anfang des Kontexts. Ein Wechsel verändert diesen Prefix. Der nächste Turn kann deshalb das ganze Fenster kalt neu verarbeiten.
Bei einem Kontext mit 250k Tokens ist das kein Detail. Zurückschalten stellt den alten Cache nicht wieder her. Es kann einfach einen zweiten Cache-Miss auslösen. Fast kann durch die andere Verarbeitung oder Route einen ähnlichen Effekt verursachen.
1. Profil vor der Session wählen
Starte Planung, Problemlösung und Umsetzung mit einem bewusst gewählten Profil. Bleibe während der Session dabei.
2. Schwierige Fragen auslagern
Nutze für ein hartes Problem eine frische Sol High Session oder einen Subagent. Schalte eine lange Sol Medium Session nicht einfach hoch.
3. Umsetzung sauber übergeben
Übertrage Plan, Entscheidungen und offene Punkte kompakt in eine frische Terra High Session. So startet die Implementierung mit sauberem Kontext.
4. Vor unvermeidbaren Wechseln kompaktieren
Kompaktieren rettet den alten Cache nicht. Es verkleinert aber das Kontextfenster, das nach dem Wechsel erneut verarbeitet werden muss.
Beim Speed-Modus bleibt Standard mein Default. Fast nutze ich nur, wenn Wartezeit der echte Engpass ist. Dann starte ich die Session bewusst damit. Ultrafast bleibt eine Vorschau und ist wegen offener Preis- und Verfügbarkeitsfragen noch keine belastbare Alltagsempfehlung.
Nicht ein Gewinner, sondern ein sauberes Routing
Mein Setup ist simpel: Sol Medium plant. Sol High löst harte Probleme. Terra High implementiert. Luna Xhigh spart Geld, wenn mehr Laufzeit akzeptabel ist.
Und ich wechsle diese Profile nicht gedankenlos mitten im Task. Gute Übergaben sind billiger als unsichtbare Cache-Misses.