Kimi K2.5: Wenn KI-Agenten im Schwarm denken
Moonshot AI bringt das erste Modell, das Bilder versteht, Code schreibt und 100 Sub-Agenten koordiniert. Ohne Bullshit.
Moonshot AI hat mit Kimi K2.5 nicht einfach ein Update gebaut. Sie haben das Spiel verändert. Das Modell basiert auf Kimi K2, einem Mixture-of-Experts-System mit 1 Trillion Parametern (32 Milliarden aktiv). Darauf haben sie 15 Billionen gemischte visuelle und Text-Tokens trainiert.
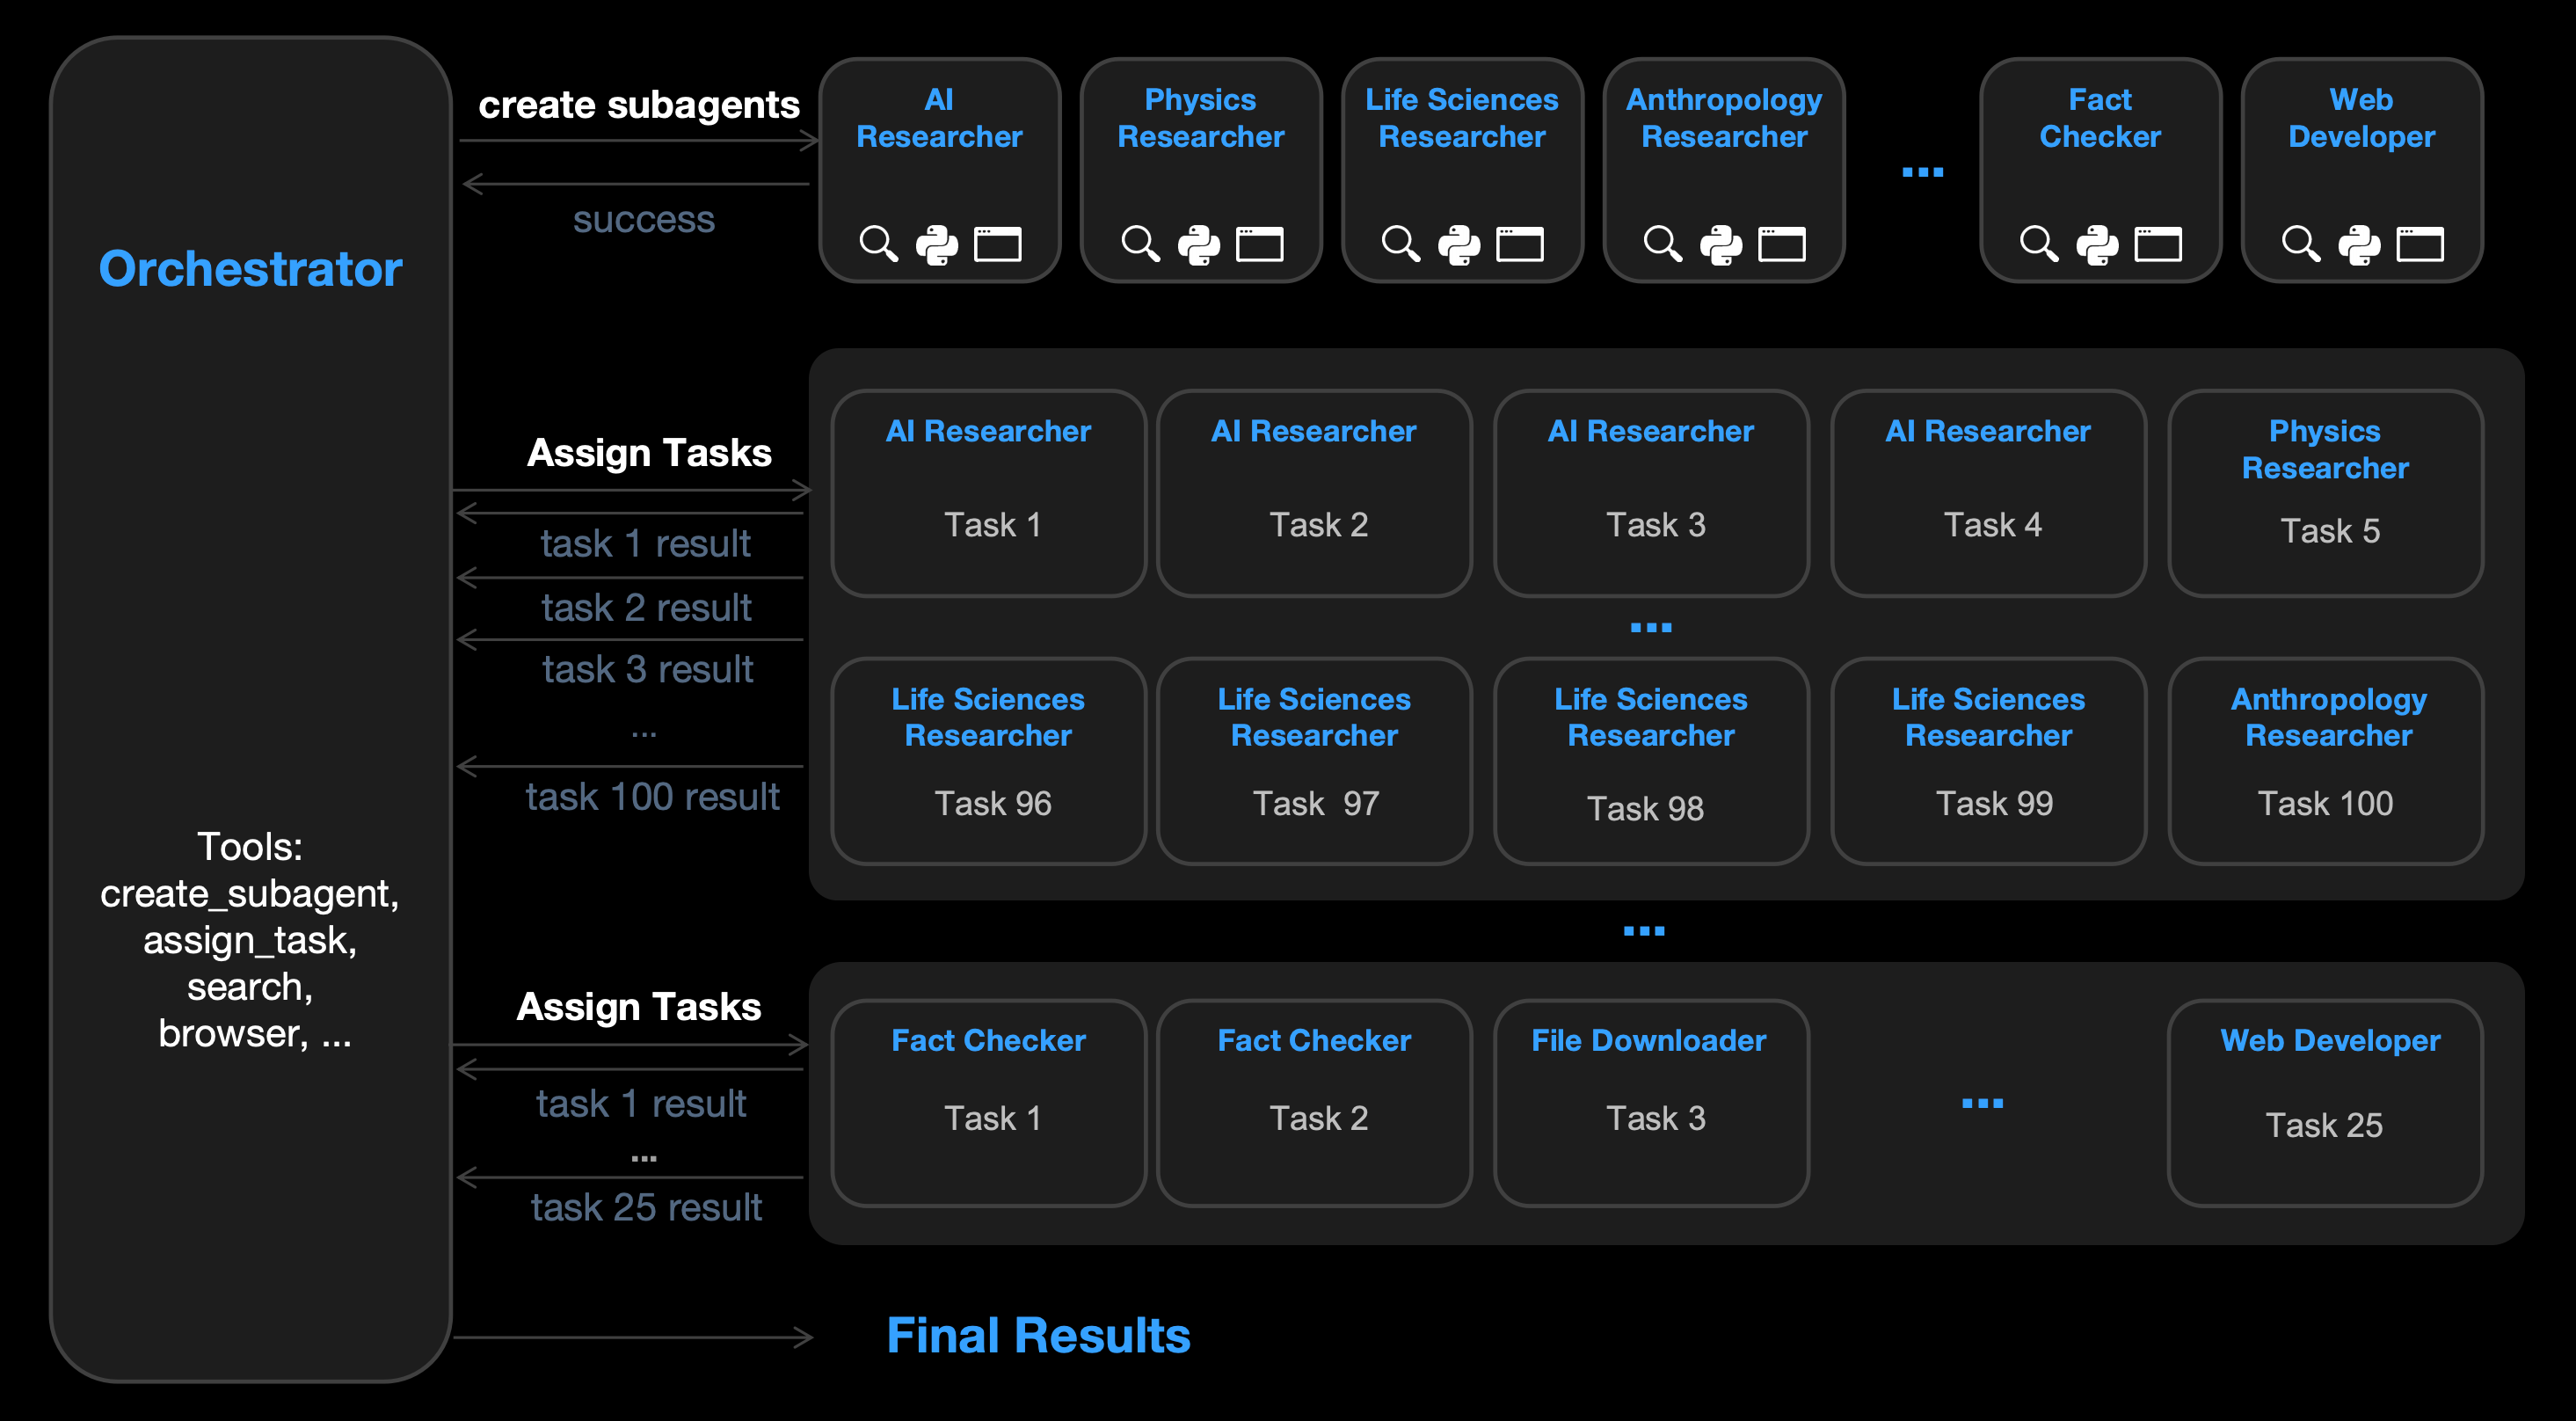
Das Resultat? Ein Modell, das Screenshots in funktionierenden Code verwandelt. Das wissenschaftliche Charts liest wie ein Mensch. Und das 100 Sub-Agenten gleichzeitig orchestriert, ohne dass ein Mensch jeden Schritt definieren muss.
Agent Swarm: Die Revolution der Arbeitsteilung
Hier wird es interessant. Die meisten KI-Systeme arbeiten linear: Ein Prompt, eine Antwort. Fertig.
Kimi K2.5 denkt anders. Es kann komplexe Aufgaben in Dutzende Teilaufgaben zerlegen. Dann spawnt es bis zu 100 spezialisierte Sub-Agenten. Jeder Agent übernimmt einen Teil. Sie arbeiten parallel. Sie verifizieren sich gegenseitig. Das Resultat ist präziser als alles, was ein einzelner Agent liefern könnte.
Beispiel: Du willst 50 Konkurrenz-Websites analysieren. Früher: Du schreibst einen riesigen Prompt und hoffst. Heute mit K2.5: Das Modell verteilt die Arbeit automatisch. Ein Agent crawlt, einer extrahiert Daten, einer synthetisiert. Alles parallel. Alles koordiniert.
Native Multimodalität
Kein Adapter-Hack. Vision und Text wurden von Anfang an gemeinsam trainiert. Das Modell versteht Bilder nicht als Anhängsel, sondern als First-Class-Input.
256K Context Window
Genug für ganze Codebases, lange Dokumente oder mehrere Research Papers gleichzeitig. Im Thinking Mode sogar bis zu 96K Tokens für interne Reasoning.
INT4 Quantization
Doppelt so schnell wie vergleichbare Modelle. Ohne Qualitätsverlust. Moonshot hat Quantization-Aware Training verwendet, keine nachträgliche Kompression.
Zwei Modi
Instant Mode für schnelle Antworten (Temperature 0.6). Thinking Mode für tiefe Reasoning-Prozesse (Temperature 1.0). Du wählst, was du brauchst.
Visual Coding: Screenshots werden zu Apps
Hier spart Kimi K2.5 den Entwicklern echte Zeit. Du zeigst dem Modell ein UI-Design. Es generiert den Code. HTML, React, Tailwind. Funktional. Responsiv.
Andere Modelle halluzinieren bei komplexen Layouts. K2.5 versteht räumliche Beziehungen. Es erkennt Buttons, Grids, Hierarchien. Und es schreibt Code, der tatsächlich so aussieht wie das Bild.
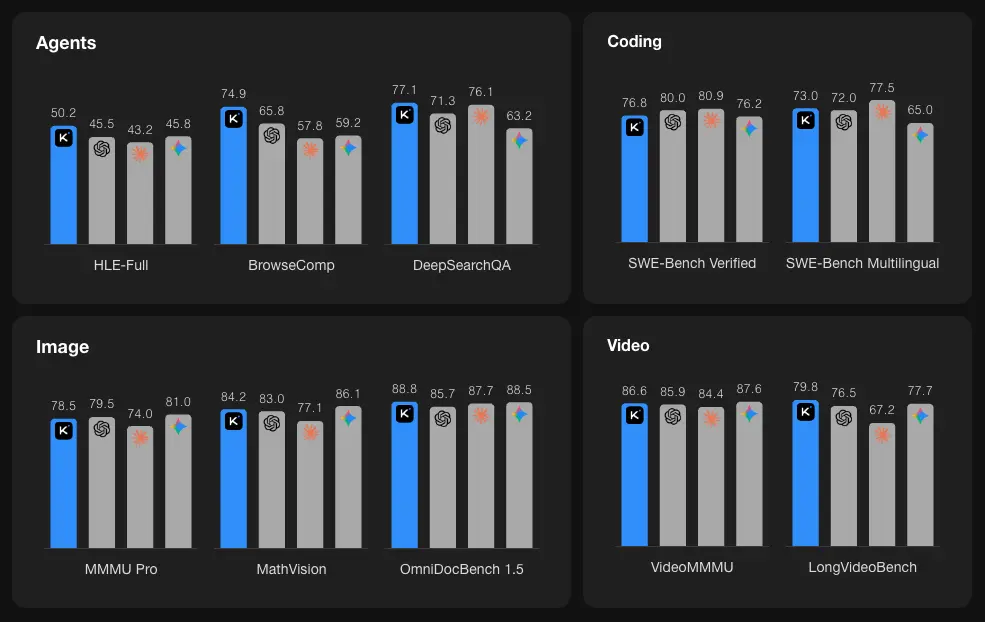
Auf SWE-Bench Verified erreicht K2.5 76,8 Prozent. Das sind echte Engineering-Aufgaben. Nicht synthetische Benchmarks. Real-world Code-Probleme in grossen Repositories.
Benchmarks: Zahlen, die zählen
Marketing-Speak interessiert niemanden. Hier sind die Fakten:
50,2% auf Humanity's Last Exam (HLE) mit Tools. Das ist State-of-the-Art für Open-Source-Modelle. HLE testet Expertenwissen über 100+ Fachgebiete.
96,1% auf AIME 2025. Ein Mathe-Wettbewerb für High-School-Cracks. K2.5 nutzt sein internes Python-Environment, um Lösungen zu verifizieren.
78,5% MMMU-Pro, 90,1% MathVista. Visuelle Reasoning-Aufgaben. Das Modell versteht nicht nur Bilder, sondern kann darüber nachdenken.
Use Case: UI-Entwicklung
Designer liefern Figma-Files. K2.5 generiert produktionsreifen Code. Frontend-Teams iterieren schneller und fokussieren auf Logic statt Layout.
Use Case: Research
Ein Agent sammelt Papers. Einer extrahiert Findings. Einer prüft Logik. Der Swarm synthetisiert einen Report. Keine manuellen Zwischenschritte.
Use Case: Document OCR
Komplexe PDFs mit Tabellen, Grafiken, mehreren Sprachen. K2.5 parst alles nativ. Kein separates OCR-Tool nötig.
Use Case: Coding Agents
Debugging über mehrere Files. Refactoring ganzer Codebases. Unit Tests schreiben. K2.5 koordiniert Sub-Agenten für jeden Schritt.
Fazit: Koordination schlägt rohe Power
Kimi K2.5 zeigt, wohin die Reise geht. Nicht grössere Modelle. Smartere Koordination.