GPT-6.1 Sol: Entscheidend ist die erledigte Aufgabe, nicht der Tokenpreis
OpenAI verspricht Leistung nahe an Astra bei deutlich tieferen Kosten. Ob sich der Wechsel lohnt, zeigen die eigenen Arbeitsabläufe. Veröffentlicht am 29. September 2026
OpenAI positioniert GPT-6.1 Sol als Modell für Softwareentwicklung, Computerbedienung und professionelle Anwendungen. Laut den vorliegenden Angaben ist es über die API verfügbar und wird schrittweise in ChatGPT Work und Codex eingeführt.
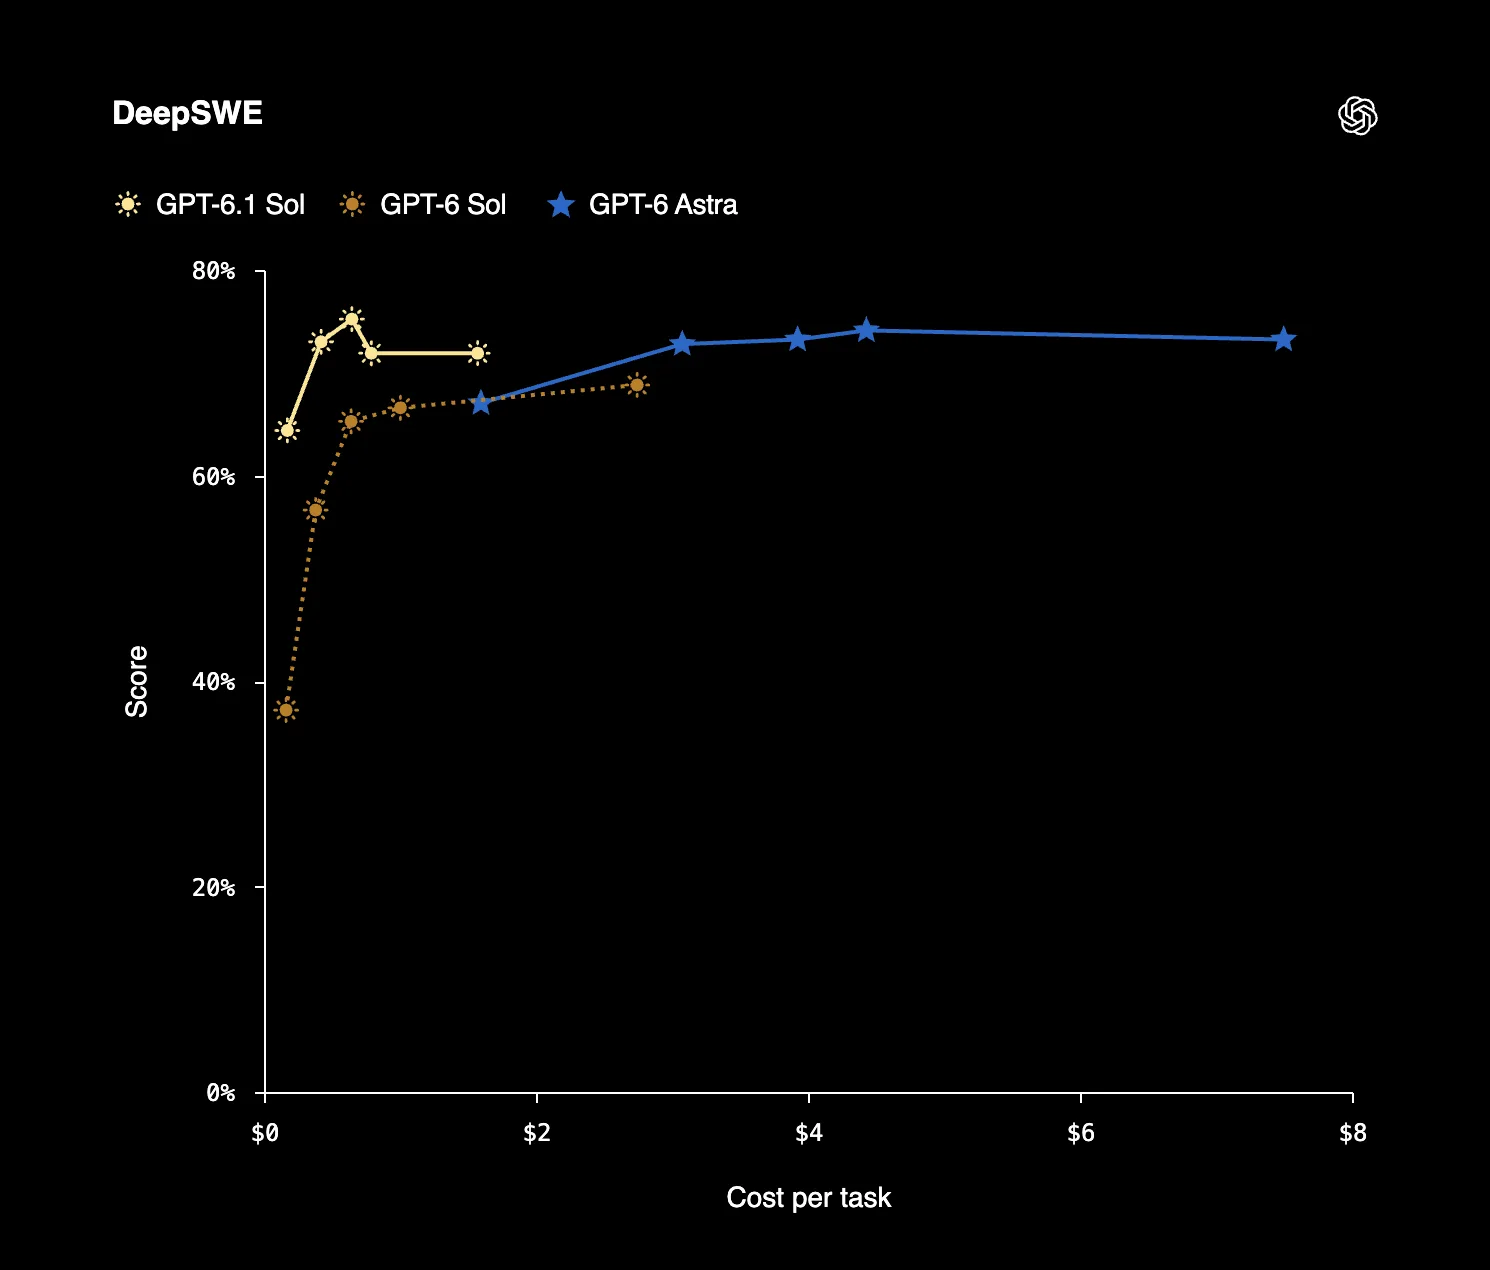
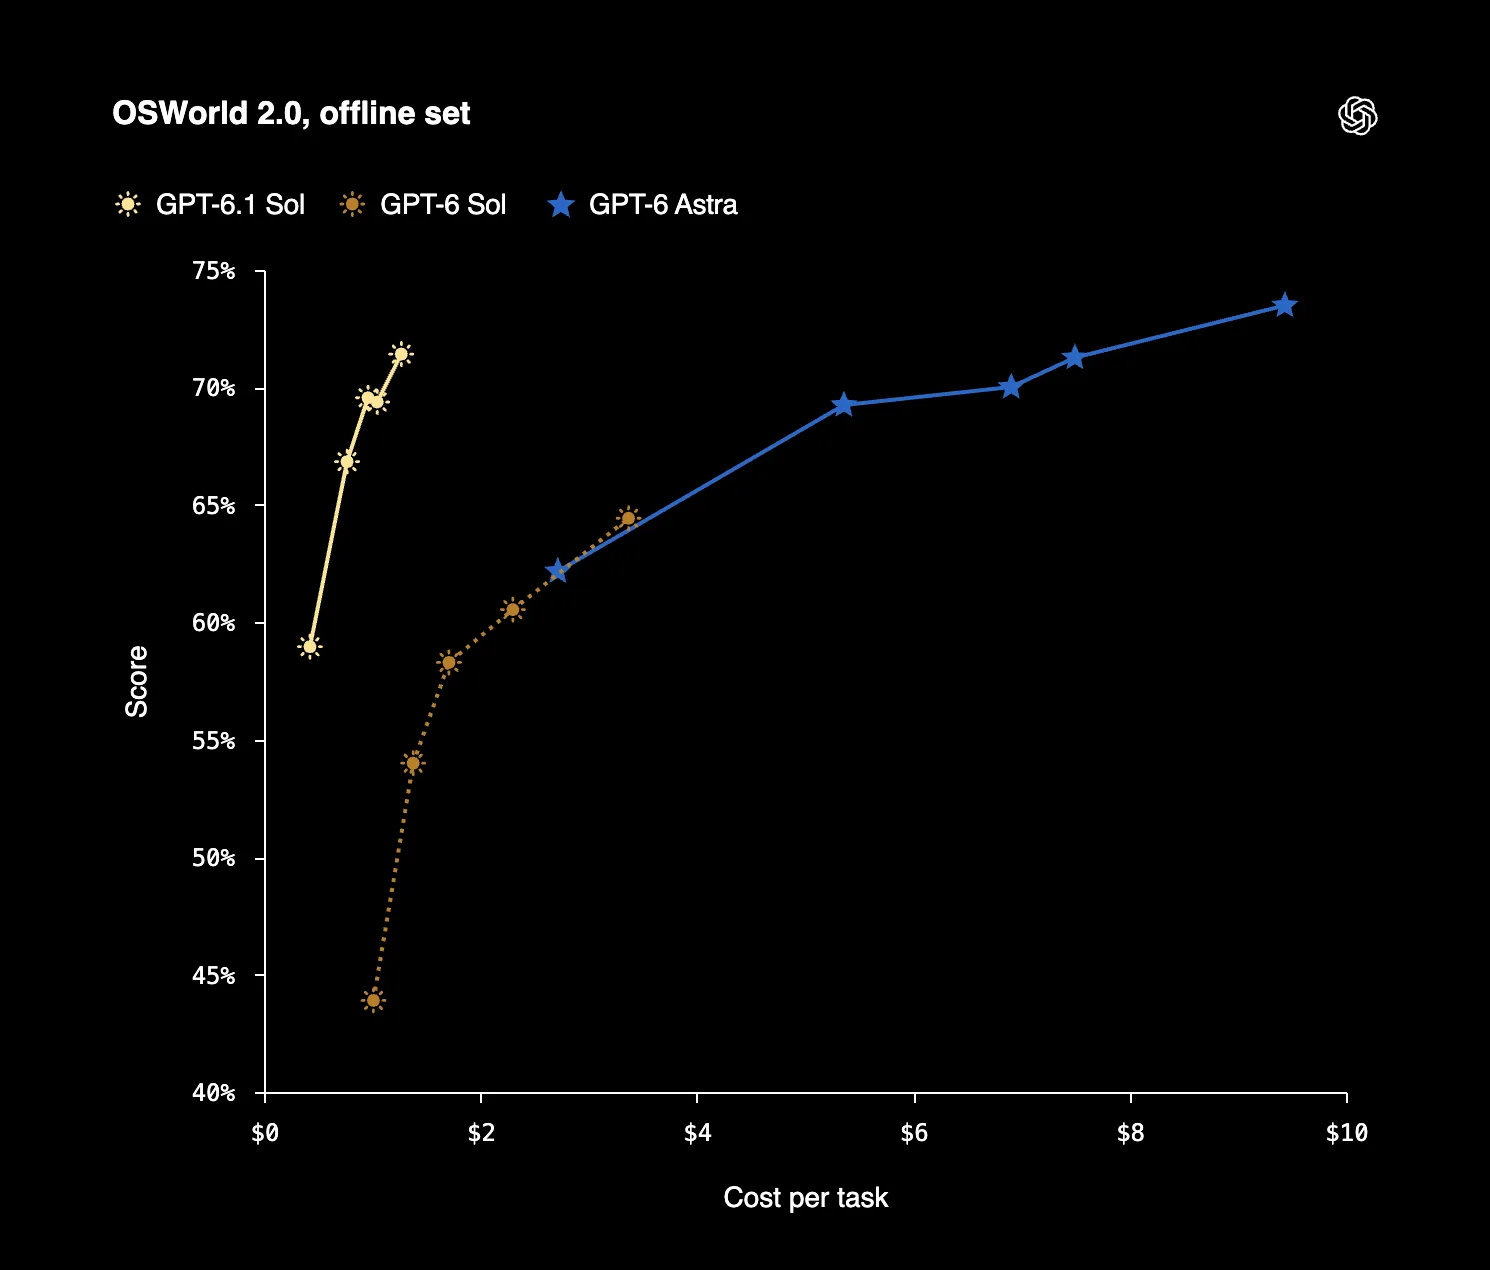
Die gemeldeten Testergebnisse sind beachtlich. Auf DeepSWE v1.1 erreicht Sol laut OpenAI die Coding-Leistung von GPT-6 Astra bei ungefähr einem Fünftel der Aufgabenkosten. Im Offline-Test von OSWorld 2.0 liegt es bei maximalem Reasoning-Aufwand 2,1 Prozentpunkte hinter Astra, bei etwa einem Siebtel der Kosten pro Aufgabe.
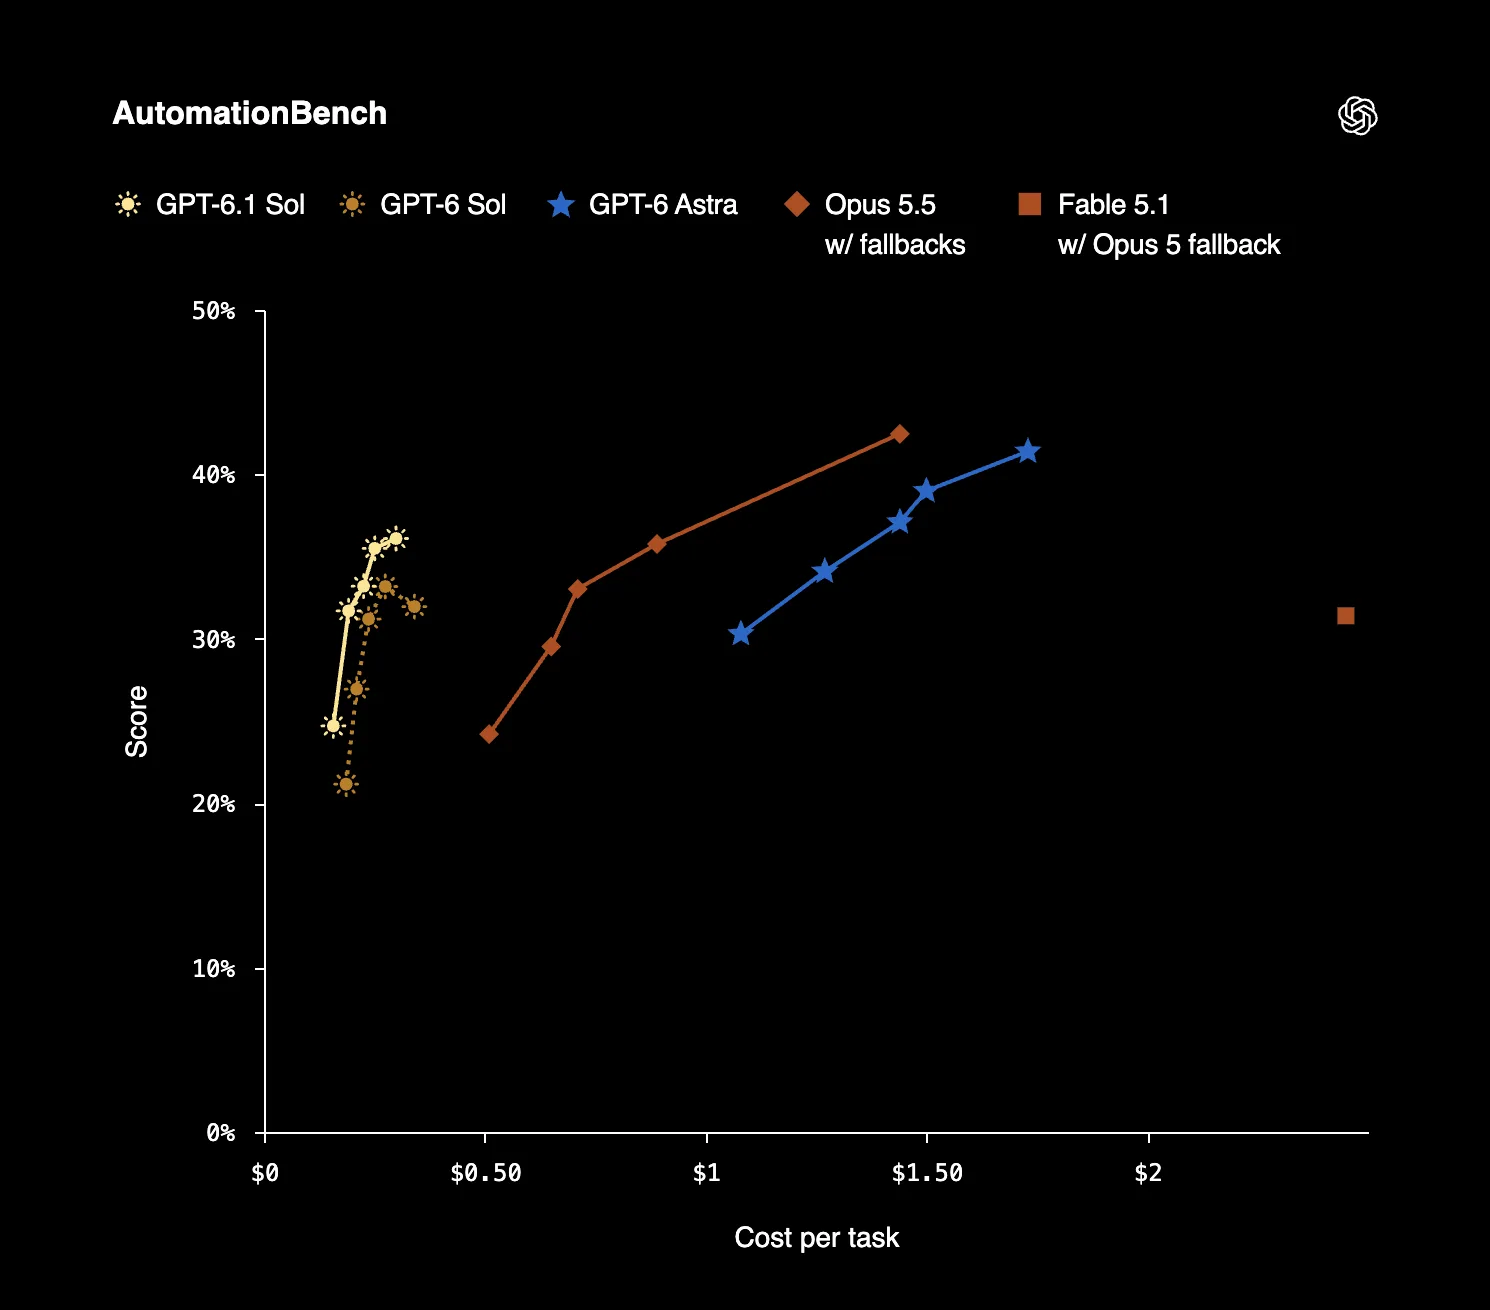
Das sind Resultate unter bestimmten Testbedingungen, keine pauschale Spargarantie. Tokenverbrauch, Reasoning-Einstellung und Aufgabenart beeinflussen die Rechnung. «Nahe an Astra» bedeutet nicht, dass Sol Astra überall ersetzt.
| Tokenart | Gemeldeter Preis pro Million Tokens |
| Eingabe ohne Cache | 2 US-Dollar |
| Gecachte Eingabe | 0,10 US-Dollar |
| Ausgabe | 10 US-Dollar |
Besonders interessant ist der Cache. Coding-Agenten und Dokumentenabläufe senden häufig dieselben Anweisungen, Code-Kontexte oder Dokumente erneut. Werden diese Eingaben als wiederverwendbar erkannt, greift der tiefere Tarif.
Bei den genannten Preisen kosten zehn Millionen gecachte Eingabe-Tokens 1 US-Dollar statt 20 US-Dollar ohne Cache. Aber wiederholter Inhalt allein garantiert noch keinen Cache-Treffer. Nicht gecachte Eingaben und erzeugte Ausgaben bleiben beim regulären Tarif.
Auch bei Faktenfehlern meldet OpenAI Fortschritte: Bei geringem Reasoning-Aufwand sinkt der Anteil fehlerhafter Antworten gegenüber GPT-6 Sol von 11,4 auf 7,7 Prozent. Der Test nutzt gezielt schwierige Gespräche, in denen Nutzer zuvor Fehler markiert hatten. Diese Quote beschreibt deshalb nicht den normalen Betrieb.
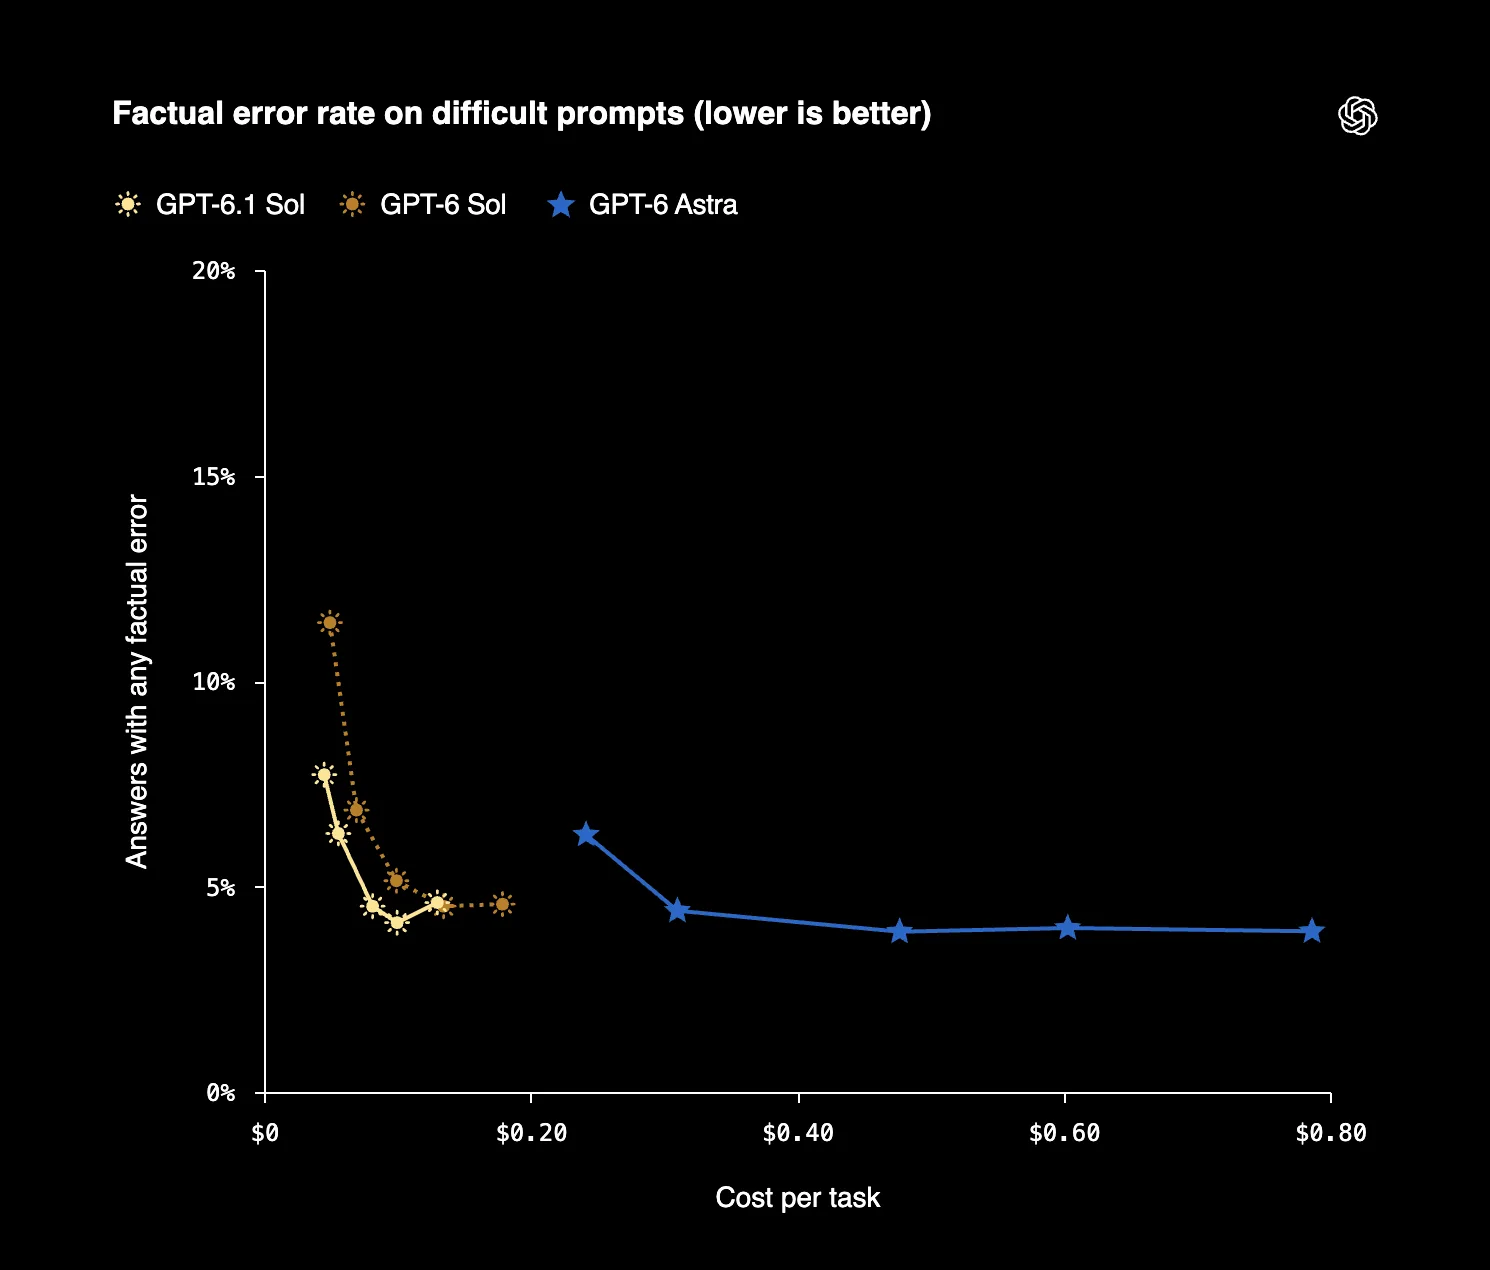
Für Teams folgt daraus kein automatischer Modellwechsel, sondern ein sauberer Vergleich. Sol und Astra müssen dieselben eigenen Aufgaben lösen, mit denselben Abnahmekriterien. Vier Messpunkte reichen, um die entscheidenden Unterschiede sichtbar zu machen.
1. Aufgabenerfolg prüfen
Vorab festlegen, wann eine Aufgabe als erledigt gilt. Dann messen, wie oft jedes Modell diese Kriterien tatsächlich erfüllt.
2. Vollständige Kosten erfassen
Eingaben, Ausgaben und tatsächliche Cache-Treffer zusammenrechnen. Auch nötige Wechsel zu Astra berücksichtigen, statt nur den günstigeren ersten Versuch zu zählen.
3. Laufzeiten vergleichen
Median und besonders lange Laufzeiten bei den benötigten Reasoning-Einstellungen messen. Benchmark-Kosten sagen noch nichts darüber aus, wie schnell der eigene Ablauf fertig wird.
4. Grenzen kontrollieren
Prüfen, wie Sol mit ausgefallenen Werkzeugen, ausdrücklichen Einschränkungen und Berechtigungen umgeht. Unbelegte Aussagen und unerlaubte Aktionen gehören ebenfalls in die Auswertung.
Günstiger zählt erst, wenn es funktioniert
Die gemeldeten Ergebnisse machen Sol zu einem Kandidaten für kostengünstigere KI-Agenten. Die Entscheidung fällt aber im eigenen Betrieb: Erledigt es die Arbeit zuverlässig und braucht es Astra selten genug als Ausweichlösung? Erst dann wird aus einem tiefen Tokenpreis eine echte Ersparnis.