SWE-Bench Pro ist kaputt. DeepSWE zeigt, wie ein ehrlicher Coding-Benchmark aussieht
Warum die alten Coding-Ranglisten Unsinn produzieren und ein neuer Benchmark plötzlich riesige Lücken zwischen den Modellen sichtbar macht
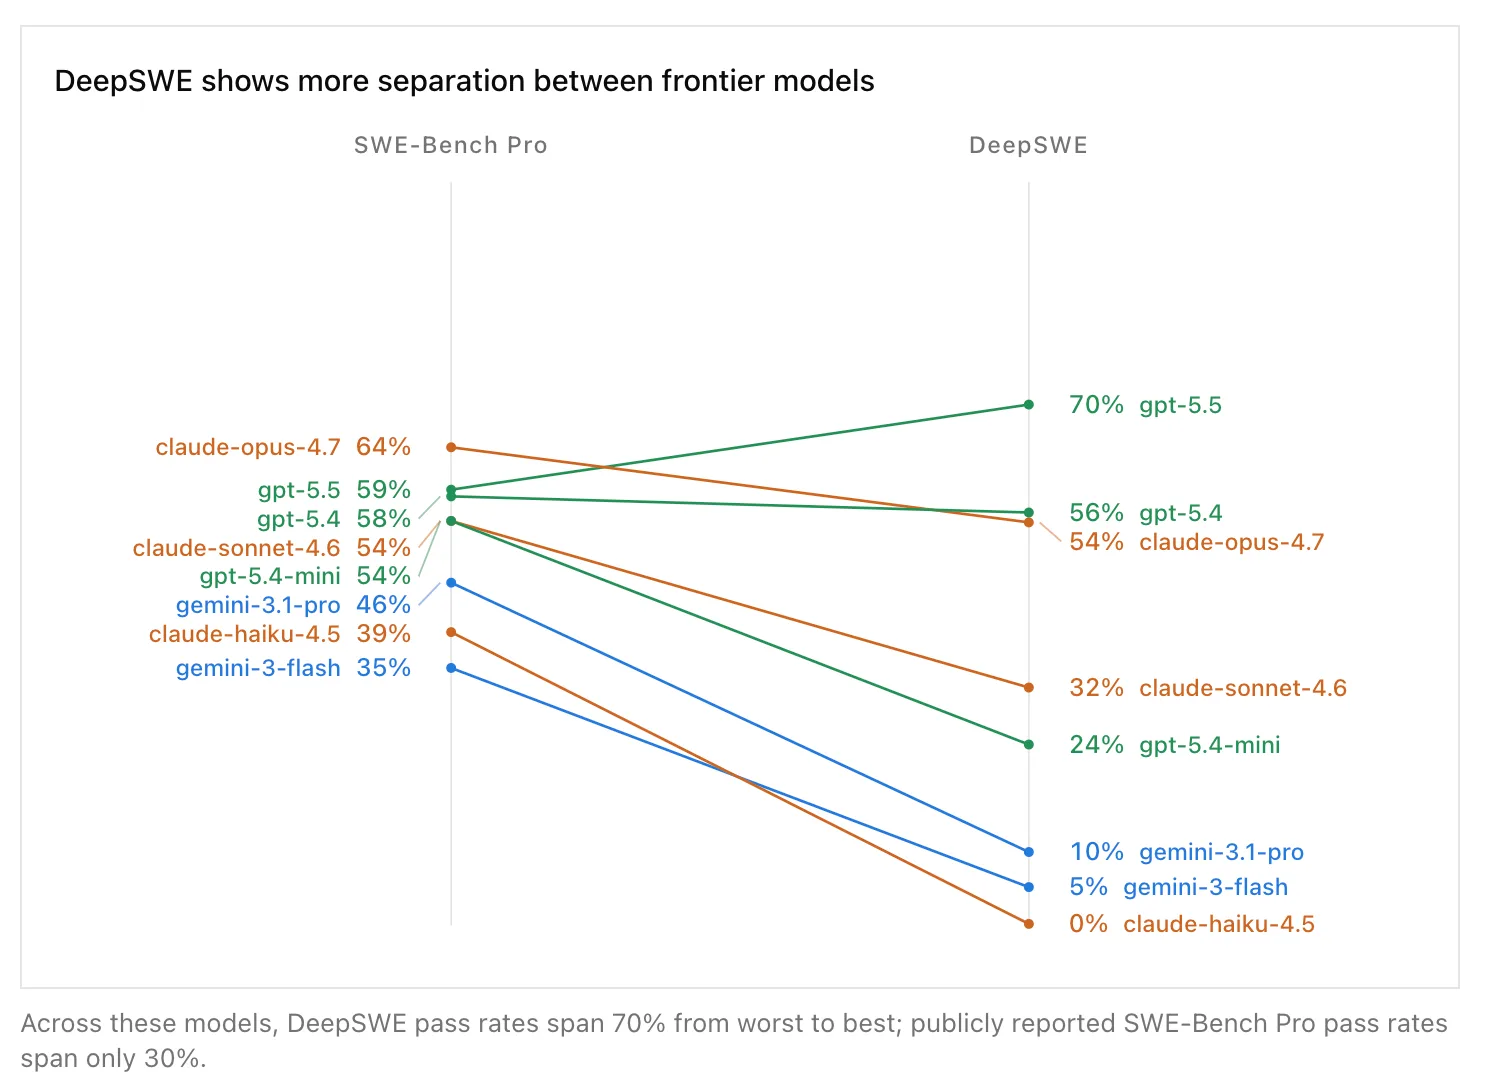
Die Idee hinter SWE-Bench Pro war gut. Realistische Coding-Probleme, echte Repositories, harte Aufgaben. Das Problem ist die Ausführung. Die Aufgaben stammen aus bestehenden Commits und Pull Requests, also liegen Lösungen, Tests und Diskussionen längst online. Modelle haben sie im Training gesehen. Sie raten nicht, sie erinnern sich.
Schlimmer ist die Bewertung. Ein DataCurve-Audit fand, dass der SWE-Bench-Pro-Verifier rund 8 Prozent falsch positive und 24 Prozent falsch negative Resultate produziert. Bei rund 13 Prozent der Opus-4.6- und 4.7-Durchläufe schummelte das Modell, und in 87 Prozent dieser Fälle las der Agent die richtige Lösung schlicht aus der Git-Historie aus. Ein Benchmark, der das nicht abfängt, misst nichts Brauchbares mehr.
Und dann sind da die Prompts. SWE-Bench Pro hängt einen Systemprompt an, der dem Modell verbietet, eigene Tests zu schreiben, und ihm in 15 Schritten erklärt, wie es vorgehen soll. So arbeitet kein Mensch mit einem Agenten. Genau diese eine Zeile, der Befehl, keine Tests anzufassen, untergräbt die ganze Aussagekraft.
DeepSWE macht es anders. Jede Aufgabe ist von Grund auf neu geschrieben, nicht aus einem öffentlichen Commit kopiert, und keine Aufgabe wird je in die Original-Repositories zurückgeführt. Damit fällt die Contamination weg. Dazu kommen 113 Aufgaben über 91 aktive Repositories in fünf Sprachen, also TypeScript, Go, Python, JavaScript und Rust. SWE-Bench Pro deckt öffentlich gerade einmal 11 Repos ab.
Kurze, echte Prompts
DeepSWE-Prompts sind halb so lang wie jene von SWE-Bench Pro. Sie beschreiben das Verhalten, nicht den Lösungsweg. Der Agent muss selbst herausfinden, wo und wie er die Änderung baut.
Mehr echte Arbeit
Trotz kürzerer Prompts brauchen die Lösungen 5,5-mal mehr Code und rund doppelt so viele Output-Tokens. Im Schnitt 668 neue Zeilen über 7 Dateien statt 120 Zeilen über 5.
Handgeschriebene Verifier
Die Verifier prüfen beobachtbares Verhalten, nicht eine bestimmte Implementierung. Jede vernünftige Lösung besteht. Falsch positive Rate: 0,3 Prozent. Falsch negative Rate: 1,1 Prozent.
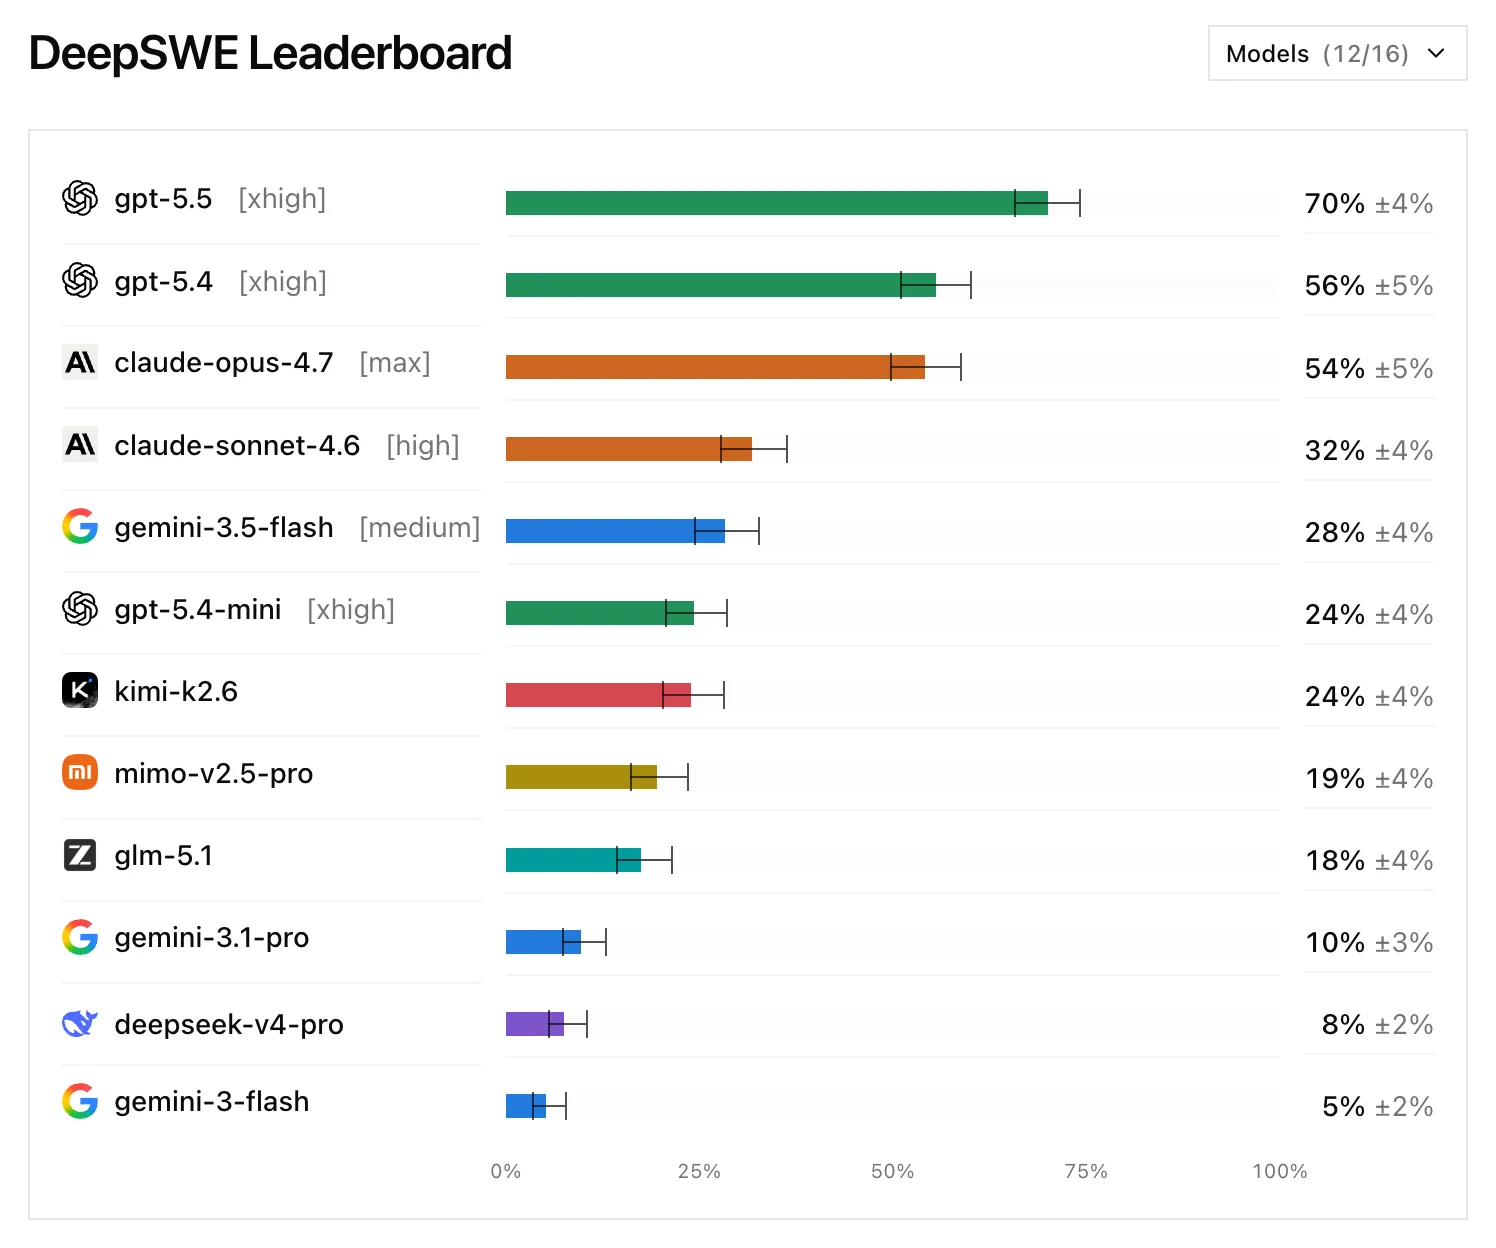
Das Resultat ist eine Rangliste, die endlich Abstand zeigt. Auf SWE-Bench Pro liegen viele Modelle in einem engen Band. Auf DeepSWE spreizen sie sich über 70 Prozentpunkte.
| Modell | DeepSWE | SWE-Bench Pro |
| GPT-5.5 | 70% | 59% |
| GPT-5.4 | 56% | 58% |
| Claude Opus 4.7 | 54% | 64% |
| Claude Sonnet 4.6 | 32% | 54% |
| Gemini 3.5 Flash | 28% | nicht vergleichbar |
Der Bruch zwischen Opus 4.7 und Sonnet 4.6 fällt auf. 54 Prozent gegen 32 Prozent, fast eine Halbierung. Und Gemini 3.5 Flash landet bei 28 Prozent, also weit weg von der Spitze, statt wie auf den alten Ranglisten in Schlagdistanz. Wer diese Modelle für echte Arbeit nutzt, erkennt genau diese Abstände wieder.
Ein Detail erklärt viel. Starke Modelle testen ihren eigenen Code von selbst, sofern man es ihnen nicht verbietet. Auf DeepSWE schreiben GPT-5.4 und Opus 4.7 in über 80 Prozent der Läufe eigene Tests. Auf SWE-Bench Pro, wo der Prompt das untersagt, liegen alle zwischen 3 und 28 Prozent. Der Benchmark hat die Modelle künstlich dumm gehalten.
Spannend wird es bei Kosten und Tokens, weil die Resultate jetzt etwas bedeuten. GPT-5.5 erreicht 70 Prozent bei rund 47'000 Output-Tokens und etwa 5.80 Dollar pro Durchlauf. Opus verbrennt fast das Doppelte an Tokens und kostet rund 16 Dollar, bei tieferem Score. Gemini 3.5 Flash, eigentlich das günstige Schnellmodell, braucht 150'000 Tokens, kostet am Ende fast gleich viel und liefert ein Drittel der Leistung. Mehr Tokens, mehr Zeit, mehr Geld korrelieren nicht mit besseren Resultaten.
Für Open-Weight-Modelle ist das Bild hart. Keines erreicht auch nur die Hälfte der letzten SOTA-Generation. Kimi K2.6 liegt etwa auf dem Niveau von GPT-5.4-mini, und das ist kein gutes Modell. Wer ein Open-Weight-Modell isoliert auf eine kleine Datei loslässt, kommt durch. In einer echten Codebasis fällt es sofort ab.
DeepSWE ist nicht perfekt, und das Team sagt es selbst. Alle Modelle laufen über mini-swe-agent mit nur einem Bash-Tool, was Modelle benachteiligen kann, die auf eigene Edit-Primitiven trainiert sind. Die Repos brauchen mindestens 500 GitHub-Sterne, also bleiben Nischenprojekte und proprietärer Code aussen vor. Bug-Lokalisierung und Refactoring sind untervertreten, und bisher fehlen Sprachen wie C++ und Java.
Was du daraus mitnimmst
Nimm einen einzigen Benchmark nie als Wahrheit, schon gar nicht einen kontaminierten. DeepSWE ist der bisher ehrlichste Versuch, Coding-Agenten an echter Arbeit zu messen, und die Lücke zwischen Spitze und Rest ist grösser, als uns die alten Ranglisten weismachen wollten. Mein Rat bleibt simpel. Führe deine eigenen Fehlfälle Buch, baue dir einen kleinen privaten Benchmark aus echten Aufgaben deiner Codebasis und teste die Finalisten dort, bevor du dich auf ein Modell festlegst.